Tiger Guard: Content Moderation für Prompts, Antworten und Kommentare, lokal auf der CPU
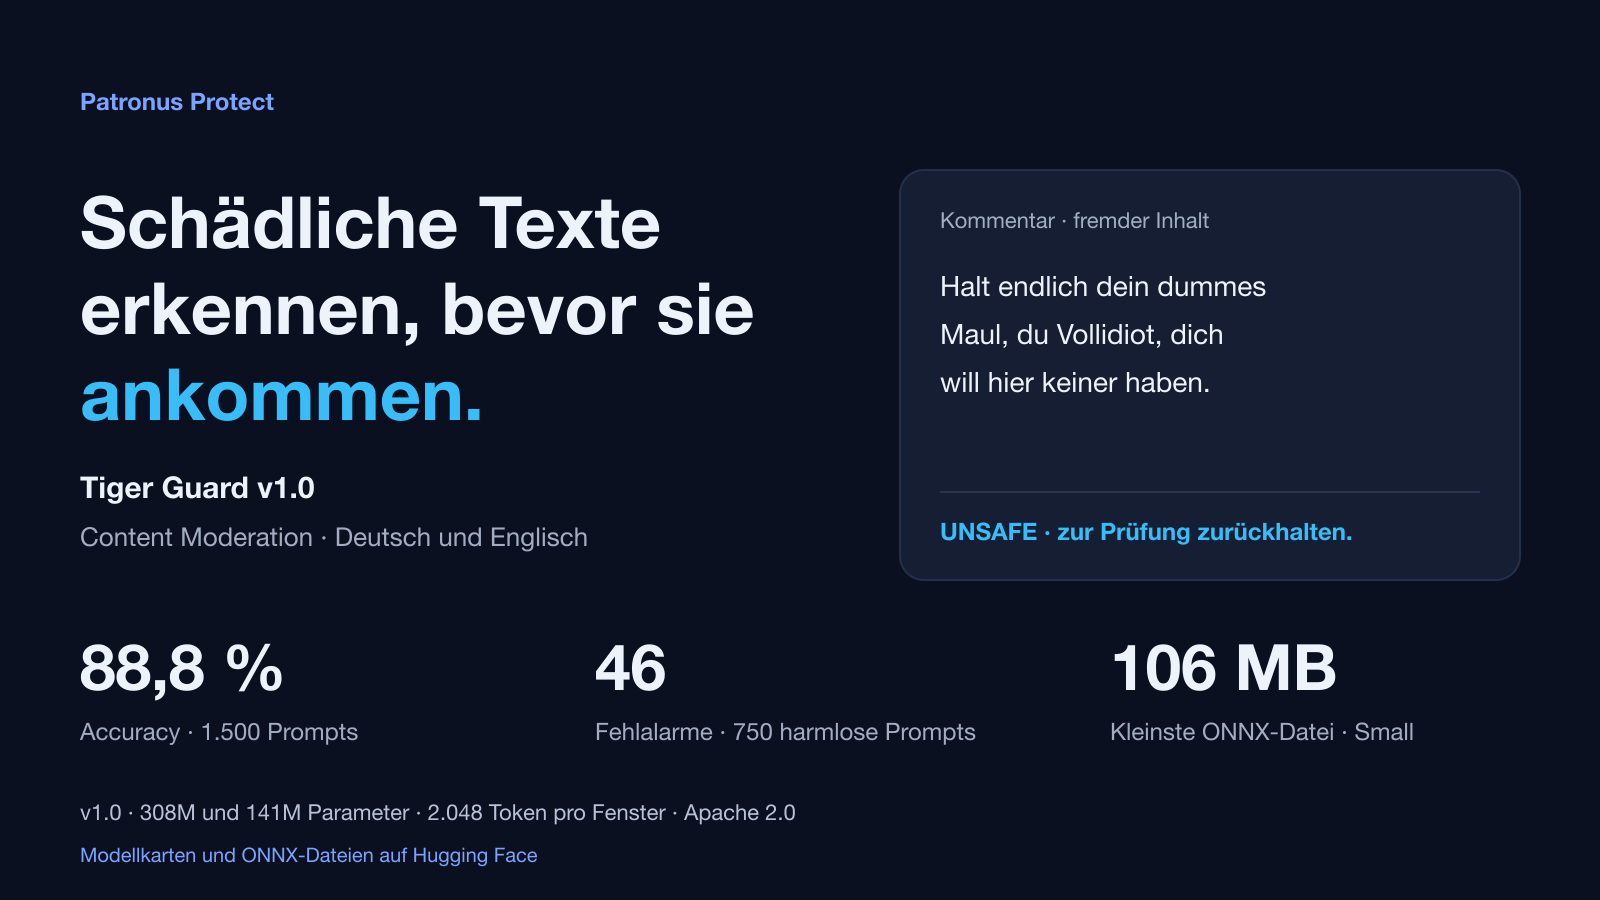
Tiger Guard ist unser neues offenes Modell für Content Moderation. Es stuft einen Text als SAFE oder UNSAFE ein, versteht Deutsch und Englisch und läuft auf deiner CPU. Es gibt zwei Größen, beide unter Apache 2.0 auf Hugging Face. Auf einem Benchmark aus 1.500 Prompts erreicht das Vollmodell 88,8 Prozent Accuracy, der beste öffentliche Klassifikator im selben Lauf 80,3 Prozent.
Kurz gesagt
- Tiger Guard prüft beide Seiten einer LLM-Anwendung, den Prompt und die Antwort, und gewöhnliche Nutzertexte wie Kommentare. Deutsch und Englisch, 2.048 Token pro Fenster, Apache 2.0.
UNSAFEumfasst zwei Arten von Inhalt: beleidigende Sprache (Toxizität, Hass, Drohungen, Sexismus, sexuelle Belästigung) und schädliche Anfragen oder Antworten in LLM-Gesprächen, etwa die Bitte um Hilfe bei Straftaten.- Das Vollmodell hat 308M Parameter und erreicht 88,8 Prozent auf dem Benchmark, Small hat 141M Parameter und 87,6 Prozent. Die kleinste ONNX-Datei von Small ist 106 MB groß.
- Gegenrede, das Zitieren von Beleidigungen zum Melden und neutrale Erwähnungen einer Gruppe sollen
SAFEbleiben.
Was zählt als UNSAFE?
Tiger Guard gibt genau zwei Labels aus. UNSAFE steht für zwei Arten von Text:
- Beleidigende Sprache: Toxizität, Hass gegen geschützte Gruppen, Beleidigungen, Schimpfwörter, Drohungen, Sexismus, sexuelle Belästigung und sexuell explizite Texte.
- Schädliche Anfragen und Antworten in LLM-Gesprächen: zum Beispiel die Bitte um Hilfe bei Straftaten, Waffen oder Selbstverletzung, oder nach den privaten Daten anderer Personen.
Gegenrede, das Zitieren von Beleidigungen, um sie zu melden, und neutrale Erwähnungen einer Gruppe sollen SAFE bleiben. Unsere Richtlinie moderiert Beleidigungen und Schimpfwörter auch dann, wenn keine geschützte Gruppe betroffen ist. Das ist strenger als Richtlinien, die nur Hate Speech erfassen. Wenn deine Plattform Fluchen erlaubt, erwarte bei diesen Texten Abweichungen.
Was das Modell nicht ist: ein Prompt-Injection-Detektor. Dafür gibt es Wolf Defender. Die beiden Aufgaben überschneiden sich kaum. Eine Injection ist meistens höflich formuliert, eine Beleidigung enthält selten eine Anweisung an das Modell.
Zwei Größen
| Modell | Basis | Parameter | Benchmark-Accuracy | Fehlalarme (von 750) | Kleinste ONNX-Datei |
|---|---|---|---|---|---|
| Tiger Guard | mmBERT-base | 308M | 88,8 % | 46 | 237 MB |
| Tiger Guard Small | mmBERT-small | 141M | 87,6 % | 47 | 106 MB |
Nimm das Vollmodell, wenn Genauigkeit am wichtigsten ist: Es liegt auf dem Benchmark 1,2 Punkte vorn und markiert im Held-out-Test weniger harmlose Prompts (4,7 gegen 6,0 Prozent). Small braucht weniger als die Hälfte des Speichers und ist das schnellere der beiden.
Wie schneidet Tiger Guard gegen öffentliche Klassifikatoren ab?
Der Benchmark besteht aus 1.500 Prompts: je 500 aus der HateCheck-Testsuite, dem Validierungssplit von Intuits Toxizitäts- und Schimpfwortdatensatz und dem Testsplit von NVIDIA Aegis AI Content Safety 1.0. In jedem Set ist die Hälfte der Prompts zu blockieren, die andere Hälfte zu erlauben. Fünf öffentliche Klassifikatoren liefen auf denselben Prompts, jeder mit seiner dokumentierten Standardentscheidung.
| Modell | Parameter | Accuracy | Unsichere erkannt (von 750) | Harmlose markiert (von 750) | Fehler insgesamt |
|---|---|---|---|---|---|
| Tiger Guard | 308M | 88,8 % | 83,7 % | 46 | 168 |
| Tiger Guard Small | 141M | 87,6 % | 81,5 % | 47 | 186 |
| Granite Guardian HAP 125m | 125M | 80,3 % | 62,4 % | 14 | 296 |
| Granite Guardian HAP 38m | 38M | 75,1 % | 58,8 % | 64 | 373 |
| RoBERTa hate speech (Dynabench R4) | 125M | 74,4 % | 51,9 % | 23 | 384 |
| toxic-bert | 109M | 71,6 % | 62,1 % | 142 | 426 |
| KoalaAI Text-Moderation | 139M | 64,4 % | 40,0 % | 84 | 534 |
So liest du die Tabelle:
- Zähle beide Fehlerarten. Granite HAP 125m und das Hate-Speech-RoBERTa markieren weniger harmlose Prompts als das Vollmodell (14 und 23 gegen 46), übersehen aber 282 und 361 der 750 unsicheren Prompts, wo Tiger Guard 122 übersieht. Insgesamt macht Tiger Guard 168 Fehler, der beste öffentliche Klassifikator 296.
- Mit einer strengeren Schwelle liegt das Vollmodell auf beiden Seiten vorn. Seine 1-Prozent-Einstellung markiert 5 harmlose Prompts und erkennt 64 Prozent der unsicheren (Granite HAP 125m: 14 und 62 Prozent).
- Die öffentlichen Modelle sind Spezialisten. Jedes ist auf seiner Art von Text stark und auf Aegis nahe am Zufall, wo die unsicheren Prompts meist Anfragen nach schädlicher Hilfe sind. Beide Tiger-Guard-Modelle bleiben auf jedem der drei Testsets über 80 Prozent.
Zwei Dinge gehören dazu. Erstens hat kein Benchmark-Text im Training gesteckt; alle HateCheck-Fälle, der Aegis-Testsplit und der Intuit-Validierungssplit wurden aus jeder Trainingsquelle entfernt, Beinahe-Duplikate eingeschlossen. Zweitens hat der Benchmark die Entwicklung gesteuert: Seine Fehleranalysen haben entschieden, welche Daten dazukamen. Die Tiger-Guard-Werte darauf sind deshalb ein Entwicklungsergebnis. Der Held-out-Test im nächsten Abschnitt wurde pro Modell genau einmal gemessen, nach dem Training.
Erkennt es schädliche Anfragen, die harmlos klingen?
PolyGuardPrompts ist der Testsplit der WildGuard-Familie: 1.725 Prompts pro Sprache, von Menschen gelabelt, etwa die Hälfte davon schädliche oder harmlose Anfragen, verpackt in Rollenspiele, Geschichten oder Anleitungen. Nach Abzug der Kategorien außerhalb unserer Richtlinie bleiben 3.123 Prompts, 1.233 davon schädlich.
| Modell | Englisch: schädliche erkannt | Englisch: harmlose markiert | Deutsch: schädliche erkannt | Deutsch: harmlose markiert |
|---|---|---|---|---|
| Tiger Guard | 83,3 % | 3,8 % | 75,3 % | 5,5 % |
| Tiger Guard Small | 83,4 % | 5,0 % | 75,3 % | 7,1 % |
| Fünf öffentliche Klassifikatoren | 0,2 bis 1,9 % | 0,0 bis 0,8 % | 0,0 bis 2,9 % | 0,0 bis 1,5 % |
Die öffentlichen Klassifikatoren erkennen fast keinen dieser Prompts. Sie wurden für beleidigende Sprache gebaut, und eine schädliche Anfrage ist meistens höflich. Dieser Test liegt außerhalb dessen, wofür sie gemacht wurden. LLM-basierte Guard-Modelle für solche Anfragen sind eine andere Größenklasse und liefen nicht mit.
Drei öffentliche Benchmarks
Drei öffentliche Testsets, die andere Guard-Modelle berichten: die englischen und deutschen Prompts von PolyGuardPrompts (400 pro Sprache, alle Schadenskategorien), ToxicChat (5.083 echte Nutzer-Prompts einer Chatbot-Demo, 362 davon toxisch) und das Evaluationsset der OpenAI-Moderation (1.680 Texte, 522 davon markiert). Die Tabelle zeigt den F1 der Klasse UNSAFE, jedes Modell mit seiner Standardentscheidung. Wir haben jedes Modell selbst auf denselben Texten laufen lassen.
| Modell | Parameter | PolyGuard Englisch | PolyGuard Deutsch | ToxicChat | OpenAI-Moderationsset |
|---|---|---|---|---|---|
| Tiger Guard | 308M | 0,871 | 0,783 | 0,736 | 0,787 |
| Tiger Guard Small | 141M | 0,867 | 0,788 | 0,720 | 0,771 |
| Content Safety Guard base (Horizon Labs) | 308M | 0,797 | 0,774 | 0,756 | 0,769 |
| Content Safety Guard small (Horizon Labs) | 141M | 0,811 | 0,772 | 0,777 | 0,763 |
| Granite Guardian HAP 125m | 125M | 0,023 | 0,000 | 0,261 | 0,671 |
| toxic-bert | 109M | 0,012 | 0,023 | 0,266 | 0,646 |
Auf den PolyGuard-Prompts liegen beide Tiger-Guard-Modelle in beiden Sprachen vorn und markieren 4,1 und 5,0 Prozent der harmlosen Prompts, die Content-Safety-Guard-Modelle 8,4 Prozent. Beide Tiger-Guard-Modelle wurden auf anderen Prompts aus derselben Datenfamilie trainiert, die Content-Safety-Guard-Modelle laut ihrer Modellkarte nicht. Auf dem OpenAI-Set hat das Vollmodell unter den Modellen, die nicht darauf trainiert wurden, den höchsten F1, der Vorsprung liegt innerhalb des Stichprobenfehlers. Auf ToxicChat liegt Content Safety Guard small vorn (0,777 gegen 0,736 für das Vollmodell und 0,720 für Small). ToxicChat und das OpenAI-Set spielten in der Entwicklung keine Rolle; jedes Modell wurde darauf einmal gemessen, nach der Veröffentlichung.
Deutsch und Englisch
Deutsch ist schwächer als Englisch. Auf identischen Prompts, dem Held-out-Test, beträgt der Abstand 8 Punkte: Beide Modelle erkennen 83 Prozent auf Englisch und 75 Prozent auf Deutsch. Auf unserem Validierungsset mit 28.996 Texten ist er größer, weil die deutschen Texte aus anderen Quellen stammen als die englischen: 80 gegen 64 Prozent beim Vollmodell, 80 gegen 61 Prozent bei Small. Die Fehlalarmrate liegt in beiden Sprachen bei etwa 4 Prozent, das ist der Standardpunkt der Modelle.
So setzt du Tiger Guard ein
Mit Transformers reicht eine Pipeline:
from transformers import pipeline

moderator = pipeline(
    "text-classification",
    model="patronus-studio/tiger-guard-content-moderation",
)

result = moderator(
    "You are a worthless idiot and everyone here hates you.",
    truncation=True,
    max_length=2048,
)
print(result)
UNSAFE bedeutet, dass die Standardschwelle von 0,5 auf der UNSAFE-Wahrscheinlichkeit überschritten ist. Die Schwelle entspricht dem Punkt, an dem das Modell 4 Prozent der harmlosen Texte unseres Validierungssets markiert. Für einen strengeren Filter liest du die Wahrscheinlichkeit aus und vergleichst sie mit einer anderen Schwelle:
| Fehlalarmrate auf dem Validierungsset | Schwelle | Benchmark-Accuracy | Fehlalarme im Benchmark | Erkannt im Benchmark |
|---|---|---|---|---|
| 1 % | 0,891 | 81,5 % | 5 | 63,6 % |
| 2 % | 0,769 | 85,6 % | 21 | 74,0 % |
| 4 % (Standard) | 0,500 | 88,8 % | 46 | 83,7 % |
Für lange Dokumente liegt inference.py im Repository: Es bewertet jedes Fenster von 2.048 Token und fasst die Fensterwerte zusammen. Die Pipeline oben schneidet lange Eingaben ab.
Für den Betrieb ohne Torch gibt es sechs ONNX-Dateien pro Modell, von FP32 (1,23 GB beim Vollmodell, 563 MB bei Small) bis INT8 mit INT4-Embeddings (237 MB und 106 MB). Auf ARM-CPUs wie Apple Silicon ändern die dynamischen INT8-Dateien ein bis drei von hundert Entscheidungen. Auf x86 sind sie nicht geeignet, dort nimmst du FP32, FP16 oder eine der beiden x86-Dateien, die ihre Gewichte als INT8 speichern und in Fließkomma rechnen. Die Modellkarte hat die Messung auf einem AMD EPYC 9554 dazu.
Wo liegen die Grenzen?
- Kein Klassifikator erkennt alles. Schreibtricks wie Leetspeak und milde Toxizität sind die häufigsten Lücken.
- Harmlose Texte können markiert werden, am häufigsten Gegenrede, die Beleidigungen zitiert, und unverblümte, aber harmlose Anfragen.
- Grenzfälle, in Aegis als "Needs Caution" gekennzeichnet, werden in etwa zwei von drei Fällen übersehen.
- Das Modell sieht nur Text. Es weiß nichts über Sprecher, Publikum oder die Regeln deiner Plattform.
- Es bewertet einen Text für sich. Eine Antwort, die erst im Zusammenhang mit ihrer Frage schädlich ist, etwa eine kurze Bestätigung, erkennt es aus der Antwort allein nicht. Wenn du Frage und Antwort als einen Text übergibst, wird er markiert, sobald eine Seite unsicher ist.
- Small kann Texte markieren, die ein Wort oder einen Satz tausendfach wiederholen, auch wenn sie harmlos sind. Das Vollmodell hat in unserer Prüfung keinen davon markiert.
Tiger Guard ist eine Schicht in einem Moderationsaufbau. Ob ein markierter Text blockiert, umformuliert oder zur Prüfung gegeben wird, entscheidet deine Anwendung.
Quellen
- Modellkarte Tiger Guard und Modellkarte Tiger Guard Small, Version 1.0. Stand: 19. November 2026.
- Benchmarks: HateCheck, Intuit combined toxicity and profanity, NVIDIA Aegis AI Content Safety 1.0, PolyGuardPrompts, ToxicChat, OpenAI moderation evaluation set.
- Die Vergleichsmodelle liefen mit ihrer dokumentierten Standardentscheidung auf denselben Texten; die Messung ist in den Modellkarten beschrieben. Stand: 19. November 2026.
Wenn du für eines der Vergleichsmodelle andere Zahlen misst oder eine Angabe für falsch hältst, schreib uns. Wir prüfen und korrigieren.
Häufige Fragen
Was ist Tiger Guard?
Tiger Guard ist ein offenes Klassifikationsmodell von Patronus für Content Moderation. Es stuft einen Text als SAFE oder UNSAFE ein, erkennt Beleidigungen, Hass, Drohungen und schädliche Anfragen auf Deutsch und Englisch und läuft lokal auf der CPU. Lizenz Apache 2.0, zwei Größen mit 308M und 141M Parametern.
Erkennt Tiger Guard Hate Speech auf Deutsch?
Ja. Deutsch und Englisch sind die trainierten und getesteten Sprachen. Im Held-out-Test mit identischen Prompts erkennt das Modell 83 Prozent der schädlichen Anfragen auf Englisch und 75 Prozent auf Deutsch. Andere Sprachen wurden nicht trainiert und nicht getestet.
Ist Tiger Guard kostenlos?
Ja. Beide Modelle stehen unter Apache 2.0 auf Hugging Face, als Transformers-Gewichte und als ONNX-Dateien bis hinunter zu 106 MB. Du betreibst sie auf eigener Hardware, ohne API-Kontingent.
Was unterscheidet Tiger Guard von Wolf Defender?
Wolf Defender erkennt Prompt Injection, also fremde Anweisungen in Texten, die ein Modell umlenken sollen. Tiger Guard erkennt schädliche Inhalte: Beleidigungen, Hass, Drohungen und Anfragen nach Hilfe bei Straftaten. Die beiden Aufgaben überschneiden sich kaum, deshalb ergänzen sich die Modelle und keines ersetzt das andere.
Braucht Tiger Guard eine GPU?
Nein. Die ONNX-Dateien laufen auf der CPU. Auf einem Apple M4 braucht das Vollmodell 19 bis 24 Millisekunden pro Fenster mit kurzen Texten, Small 13 bis 14 Millisekunden.