Gefährliche Shell-Befehle erkennen
Experimenteller Forschungsbericht. Datenstand: 4. bis 6. Oktober 2026.
Was Kestrel auf Bash leistet, wie weit zusätzliche Trainingsdaten tragen und weshalb ein kleiner Encoder trotz Pretraining und vollständiger Skriptabdeckung nicht automatisch besser wird.
Ein Coding-Agent kann mit einem einzigen Shell-Aufruf ein Projekt bauen, einen Installer ausführen oder wichtige Dateien löschen. Für eine Sicherheitskomponente sieht das zunächst ähnlich aus: Text hinein, eine Entscheidung heraus. Die eigentliche Frage lautet, wie zuverlässig sich riskante Aufrufe erkennen lassen, ohne gewöhnliche Entwicklungsarbeit zu unterbrechen.
Wir haben dafür drei Ansätze untersucht: Kestrel mit seinen offiziellen veröffentlichten Gewichten, einen erweiterten linearen Klassifikator und einen eigenen kleinen Hadamard-Encoder mit Masked-Language-Model-Pretraining. Neben dem ursprünglichen Bash-Benchmark betrachten wir PowerShell, CMD, synthetische Obfuskationen und vollständige PowerShell-Skripte.
Unser wichtigstes Ergebnis: Der erweiterte lineare Ansatz liefert in diesen Experimenten die robusteste Kombination aus Erkennung und niedriger Fehlalarmrate. Der Encoder verbessert sich auf langen Skripten deutlich, wenn er alle Chunks verarbeitet. Eine gemeinsame strenge Blockierschwelle und lange harmlose Kommentar-Präfixe offenbaren jedoch erhebliche Schwächen. Gute Klassifikation und zuverlässiges Blockieren sind zwei unterschiedliche Anforderungen.
1. Das Problem: Risiko ist mehr als ein gefährliches Wort
Ein Scanner könnte nach rm, curl oder Invoke-Expression suchen. Damit würde er schnell viele legitime Aufgaben blockieren. Umgekehrt lassen sich riskante Handlungen ohne auffälligen Klartext ausdrücken: durch kodierte Nutzlasten, zusammengesetzte Befehle oder Skripte, in denen der entscheidende Teil erst nach einem langen Header steht.
Auch ein Lernverfahren benötigt einen klaren Zielbegriff. Wir klassifizieren hier den vom Datensatz gelabelten Risk-Status des eingereichten Textes. Das ist kein vollständiges Urteil über Absicht oder tatsächliche Auswirkung. Ein Download mit anschließender Ausführung kann Teil einer legitimen Installation sein. Dynamische Ausführung ist abhängig von der Nutzlast. Selbst ein destruktiv formulierter Befehl kann durch Betriebssystemschutz abgefangen werden.
Diese Unterscheidung ist praktisch relevant. Ein Agentensystem muss möglichst viele riskante Aktionen erkennen, darf aber nicht bei jedem harmlosen Aufruf alarmieren. Wir berichten deshalb Recall als Anteil erkannter riskanter Fälle und FPR als Anteil fälschlich beanstandeter sicherer Fälle. F1 kombiniert Precision und Recall; sein Wert hängt auch vom Klassenverhältnis des Tests ab. Ein gutes F1-Ergebnis allein belegt noch keinen brauchbaren Betriebspunkt für einen synchronen Blockiermechanismus.
2. ShellRisk-Bench und Kestrel als Ausgangspunkt
ShellRisk-Bench untersucht einzelne Shell-Command-Einreichungen. Der veröffentlichte Bash-Test enthält 4.194 Fälle: 193 riskante und 4.001 sichere Commands. Die Aufteilung stammt aus denselben Quellen wie der Trainingsbestand; sie misst also Generalisierung auf neue Strings bekannter Quellen, nicht auf beliebige neue Shell-Dialekte. Ganze Skripte und mehrteilige Sessions gehören nicht zur ursprünglichen Aufgabe. 1
Kestrel ist ein kompakter lokaler Klassifikator. Sein veröffentlichtes JSON-Artefakt enthält 50.000 Zeichen-N-Gramme, Gewichte, IDF-Werte und eine Schwelle. Für die veröffentlichten ShellRisk-Bench-Einzelurteile ergeben sich 178 erkannte riskante Fälle und zehn Fehlalarme: 92,2 % Recall, 0,25 % FPR und 93,4 % F1. Diese Kombination ist auf dem ursprünglichen Test stark. 1
Das offizielle Modell ist auf Hugging Face verfügbar. Wir haben es heruntergeladen, die veröffentlichte SHA-256-Prüfsumme geprüft und festgestellt, dass es bytegleich mit dem zuvor in unseren Experimenten verwendeten Artefakt ist. Es handelt sich um ein portables JSON-Modell, keinen Transformers-Checkpoint. 2
Methodik zum Kestrel-Vergleich. Die erweiterten Auswertungen verwenden die offiziellen Gewichte mit unserer dokumentierten Python-Inferenz:
char_wb-N-Gramme 3-5, Kleinschreibung, sublineare Termfrequenz, IDF und L2-Normalisierung. Im ursprünglichen Benchmark zitieren wir die veröffentlichten Urteile; die zusätzlichen Tests beziehen sich auf die offiziellen Gewichte mit dieser Inferenz. Das Modell selbst ist identisch.
3. Die Generalisierungslücke
Ein starker Bash-Benchmark beantwortet noch nicht, wie ein Modell mit PowerShell, CMD oder einer Base64-Nutzlast umgeht. Die Schreibweisen unterscheiden sich, ebenso die typischen Argumente und die Bedeutung einzelner Operatoren. Ein linearer Klassifikator kann sehr präzise bekannte Muster erkennen und trotzdem an einer neuen Verteilung scheitern.
Für den Transfervergleich verwenden wir 918 zurückgehaltene Commands aus einem erweiterten Shell-Safety-Datensatz: 374 riskante und 544 sichere Fälle aus POSIX, PowerShell und CMD. Die Schwellen werden separat für jedes Modell auf derselben externen Command-Validierung gewählt. Von deren 1.666 sicheren Beispielen dürfen höchstens 16 einen Fehlalarm auslösen. Die Testdaten bestimmen diese Schwellen nicht. Der Command-Test besteht aus 735 POSIX-, 119 PowerShell- und 64 CMD-Fällen; darunter sind 292, 58 beziehungsweise 24 positive Beispiele.
| Modell und Betriebspunkt | Erkannt / riskant | Fehlalarme / sicher |
|---|---|---|
| Kestrel, native Schwelle | 209/374 · 55,9 % | 226/544 · 41,5 % |
| Kestrel, 1-%-Validierungs-FPR | 8/374 · 2,1 % | 6/544 · 1,1 % |
| Patronus Linear, gleich kalibriert | 321/374 · 85,8 % | 5/544 · 0,9 % |
| Patronus Encoder, gleich kalibriert | 315/374 · 84,2 % | 5/544 · 0,9 % |
Die Kestrel-Scores trennen diese neuen Labels bei niedriger FPR schlecht. An der nativen Schwelle sind die Fehlalarme hoch; eine strengere Schwelle reduziert sie, verwirft aber fast alle positiven Fälle. Die zusätzlich trainierten Patronus-Modelle schneiden deutlich besser ab.
Das ist kein Architekturvergleich mit identischen Trainingsdaten: Kestrel wurde für eine andere Aufgabe veröffentlicht, während unsere Modelle Beispiele der neuen Quellen im Training erhalten. Der Versuch zeigt eine Übertragungslücke des ursprünglichen Modells und einen Gewinn durch Anpassung an die Zielverteilung. Er belegt keine universelle Überlegenheit gegenüber Kestrel.
4. Experiment I: Ein Hadamard-Encoder mit Pretraining
Die Hypothese hinter dem Encoder war naheliegend: Ein Modell mit Attention könnte Beziehungen zwischen Befehl, Argumenten und Nutzlast lernen, statt sich ausschließlich auf lokale Zeichenmuster zu stützen. Wir verwendeten eine kleine Architektur mit sechs Layern, Breite 256 und rund 1,29 Millionen Parametern.
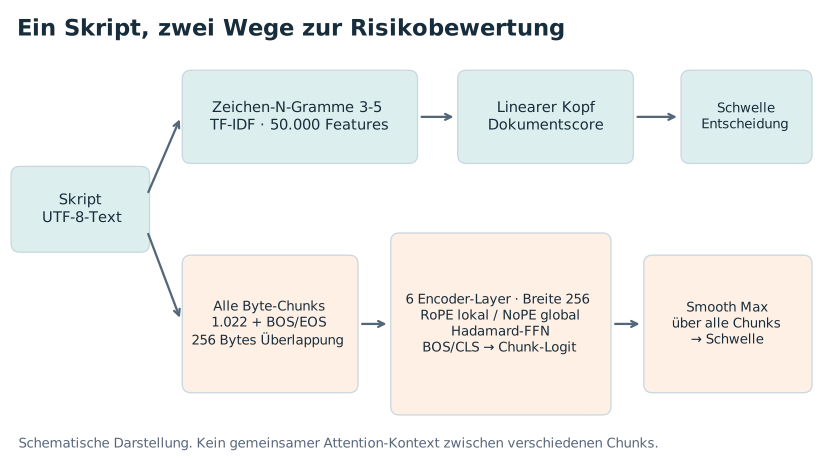
Abbildung 1. Der lineare Ansatz erzeugt einen Score aus dem gesamten Dokument. Der Encoder verarbeitet jeden Chunk unabhängig und aggregiert anschließend dessen Risiko-Logit. Die Diagrammblöcke sind schematisch, nicht maßstabsgetreu.
Die Encoder-Blöcke wechseln zwischen lokaler Attention mit Rotary Position Embeddings und globaler Attention ohne explizite Positionskodierung innerhalb eines Chunks. Der Hadamard-initialisierte Feed-forward-Teil verwendet trainierbare strukturierte Mischungen. Er ist weder ein CNN noch mHC-Residual-Mixing. Ein BOS/CLS-Token liefert die Repräsentation für den binären Ausgabekopf.
Beim Masked Language Modeling werden ausgewählte Eingabetokens verdeckt oder ersetzt und vom Modell rekonstruiert. Für uns ist ein Token ein UTF-8-Byte, kein Wort oder Subword. Das Verfahren trainiert zunächst die Darstellung von Shell-Text; es liefert noch keine Risk-Labels. Die vorherige erweiterte Pretraining-Runde verarbeitete 54,72 Millionen Byte-Token-Views. Für den längeren Kontext kamen weitere 11,82 Millionen hinzu: 1,34 Millionen POSIX-, 9,84 Millionen PowerShell- und 0,64 Millionen CMD-Bytes. Wiederholt gezogene Bytes zählen mehrfach; diese Zahlen sind keine Mengen einzigartiger Trainingsdaten.
Die zusätzliche Runde startet vom bereits angepassten Encoder-Checkpoint. Anschließend trainieren wir vier weitere Epochen auf vollständigen Dokumenten. Der ausgewählte Checkpoint und die Aggregationstemperatur werden über die mittlere Validierungs-AP von fünf Gruppen bestimmt. Die finale Temperatur ist τ = 1. Die Risk-Trainingsmenge umfasst 32.335 Dokumente und 100.956 Chunks pro Epoche.
Von einem Präfix zum vollständigen Skript
Die frühere Variante sah nur die ersten 510 Bytes eines Dokuments. Die neue Variante verwendet 1.024 Positionen: maximal 1.022 Byte-Tokens plus BOS und EOS. Benachbarte Chunks überlappen um 256 Bytes. Klassifikationstraining und Inferenz berücksichtigen alle Chunks; es gibt dort keinen Sampling-Cap. Beim Aufbau des MLM-Pools werden dagegen bis zu 32 Fenster pro Quelldokument ausgewählt.
Die Chunk-Logits zᵢ werden mit einem normalisierten Smooth Max zu einem Dokumentscore zusammengeführt:
S = τ · [log Σᵢ₌₁ᴺ exp(zᵢ / τ) − log N]
Für einen einzelnen Chunk ist S gleich dessen Logit. Identische Scores ergeben unabhängig von der Chunk-Anzahl denselben Wert. Ein Dokumentlabel trainiert diese gemeinsame Aggregation; nicht jeder Chunk eines riskanten Skripts wird pauschal als positiv gelabelt. Die Gradienten laufen über die Smooth-Max-Gewichte zu den Chunks zurück.
Der Vorteil ist vollständige Eingabeabdeckung bei begrenztem Speicherbedarf. Die Grenze ist ebenso wichtig: Ein Chunk kennt den Inhalt anderer Chunks nicht. Ein Variablenwert am Skriptanfang und seine gefährliche Verwendung viele Chunks später werden nicht durch dokumentweite Attention verbunden.
5. Experiment II: Kestrel Expanded
Die zweite Hypothese war einfacher: Vielleicht fehlt dem ursprünglichen linearen Ansatz hauptsächlich die passende Datenabdeckung. Wir behalten deshalb Zeichen-N-Gramme 3-5, einen TF-IDF-Vectorizer mit 50.000 Merkmalen und einen linearen logistischen Klassifikator bei. Hinzu kommen Beispiele aus mehreren Shells, positive und negative PowerShell-Skripte sowie synthetische Obfuskationsvarianten.
Kestrel Expanded ist hier unser experimenteller Name für diese Erweiterung der Modellfamilie. Das konkrete Modell heißt im Code linear_updated; es ist ein neu trainiertes Patronus-Modell und keine neue offizielle Kestrel-Version. Es verarbeitet den vollständigen Text, nicht nur ein 510-Byte-Präfix.
Die zusätzliche Fit-Menge umfasst 18.918 Beispiele, darunter 10.672 positive und 8.246 negative. Die vorhandenen Original-Splits bleiben erhalten. Exakte Duplikate, widersprüchliche identische Commands und erkannte Überschneidungen mit zurückgehaltenen Daten werden ausgeschlossen. Die erweiterte Trainingsmenge geht auch in die Encoder-Versuche ein.
Was die Datenlabels bedeuten. In den Quellen stehen unter anderem
sudo systemctl stop apparmorals Abschalten eines Schutzes undInvoke-Expression $env:PAYLOADals dynamische Ausführung. Gleichzeitig sindcat /proc/net/tcpundnslookup evil.ioals Datenabfluss markiert. Allein aus diesen beiden Commands lässt sich ein externer Datenabfluss nicht ableiten. Die Labels sind daher eine messbare Zielgröße, aber kein unabhängig bestätigtes Malware-Verdikt.
6. Ergebnisse: Kontext, Obfuskation und Schwellen
Mehr Kontext hilft bei langen Skripten
Der PowerShell-Skripttest enthält je 1.000 positive und negative Dateien. Alle 2.000 Skripte sind länger als das frühere 510-Byte-Fenster. Der Chunk-Encoder wertet insgesamt 349,22 MB Originaltext in 456.219 Chunks aus; ausgelassene Bytes: null. Der Test umfasst die zuvor ausgewählten Dateien bis 1 MiB.
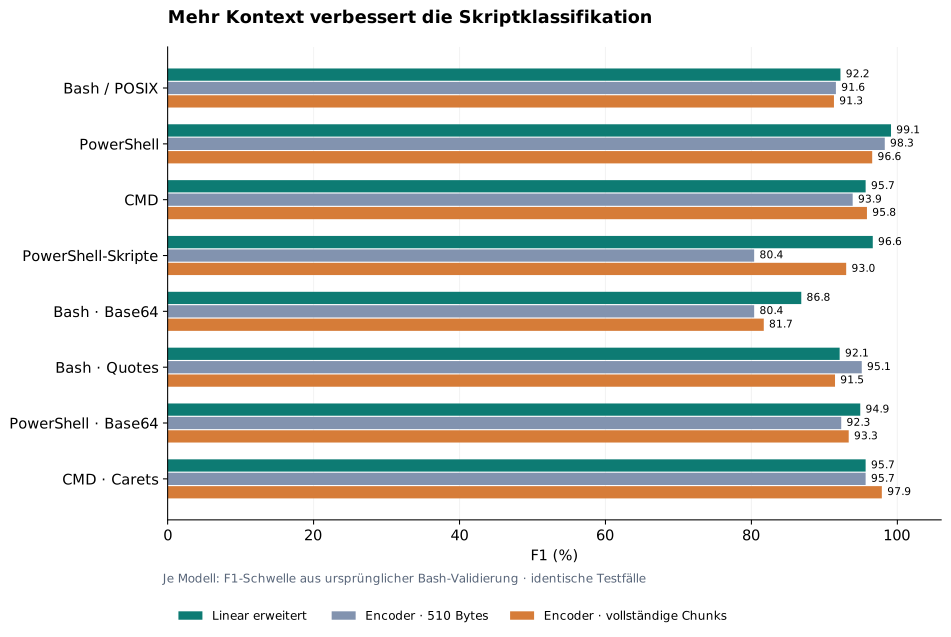
Abbildung 2. F1 bei jeweils auf der ursprünglichen Bash-Validierung gewählten F1-Schwellen. Der Skriptwert des Encoders steigt von 80,38 auf 92,99 %. Linear erreicht 96,63 %. Die Modelle stehen hier nicht an identischen Fehlalarmraten.
Die längere Encoder-Variante erreicht auf Skripten 89,50 % Recall bei 97,00 % Spezifität. Linear liegt bei 96,10 % Recall und 97,20 % Spezifität. Beim selben neuen Encoder und derselben Schwelle liefert nur der erste 1.022-Byte-Chunk 88,71 % F1; die vollständige Aggregation erreicht 92,99 %. Dieser interne Vergleich zeigt einen Nutzen der zusätzlichen Chunks.
Gegenüber dem vorherigen 510-Byte-Modell steigt F1 um 12,61 Prozentpunkte. Das ist jedoch kein isolierter Beweis für Chunking allein: Fensterlänge, zusätzliche MLM-Anpassung, Dokumenttraining und Pooling änderten sich gemeinsam. Das gepaarte Bootstrap-Verfahren gruppiert Skripte mit identischem früherem Präfix, beseitigt aber keine Quellen- oder Malware-Familienabhängigkeiten.
Obfuskation verändert die Darstellung
Die gepaarten Tests verändern denselben ursprünglichen Command: Ein Bash-Wrapper transportiert den Text als Base64, Quote-Varianten verändern die Schreibweise des ausführbaren Namens, PowerShell-Varianten verwenden UTF-16/Base64 und CMD-Varianten Caret-Escaping. Das untersucht Robustheit gegen konkrete textuelle Transformationen, nicht gegen jede Form realer Obfuskation. Varianten desselben Originals sind keine unabhängigen neuen Angriffe.
Eine strenge Schwelle verändert das Bild
Für einen Blockiermechanismus interessiert besonders die Leistung bei niedriger FPR. Wir untersuchen zusätzlich eine gemeinsame Schwelle, die in jeder von acht Kalibriergruppen höchstens 0,5 % Fehlalarme zulässt. Dazu werden die früheren Testfälle deterministisch in ungefähr 70 % Kalibrierung und 30 % Holdout aufgeteilt; Varianten folgen ihrem Original. Linear und Encoder verwenden exakt dieselbe Aufteilung und Regel.
Diese Analyse ist explorativ: Sie verbraucht einen Teil früherer Testdaten, und mögliche Schwellen wurden im Laufe der Analyse betrachtet. Ihre Zahlen sind keine neue unabhängige Bestätigung. Der resultierende Cut beträgt für Linear 1,805 und für den Encoder 7,46875.
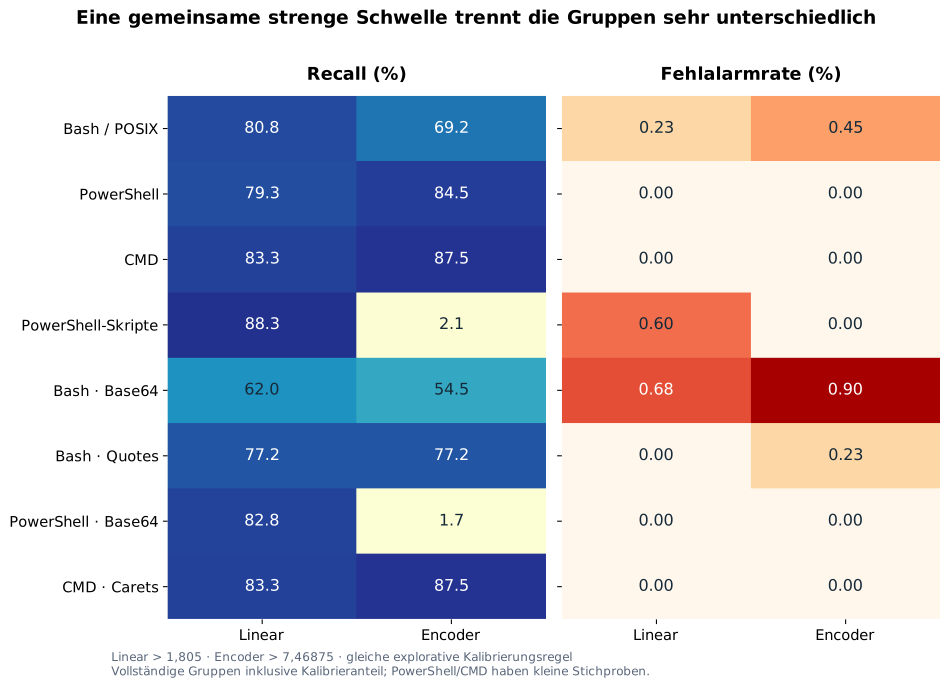
Abbildung 3. Vollständige Gruppen einschließlich des Kalibrieranteils. Die dunkle Recall-Farbe steht für bessere Erkennung; bei der FPR steht dunkler für mehr Fehlalarme. Kleine PowerShell- und CMD-Stichproben erlauben keine Aussage, dass die wahre FPR null sei.
Der Encoder liegt bei normalen PowerShell- und CMD-Commands leicht vor Linear. Bei Bash-Base64 ist Linear besser; bei Bash-Quotes ist der Recall gleich. Der auffälligste Befund betrifft PowerShell-Base64 und lange Skripte: Der Encoder fällt auf 1,72 % beziehungsweise 2,10 % Recall, während Linear 82,76 % beziehungsweise 88,30 % erreicht.
Die bindende Encoder-Kalibriergruppe ist Bash-Base64: Ihre sicheren Fälle erzwingen den höchsten Cut. Die Score-Skalen der übrigen Gruppen passen dazu nicht gut. Beim niedrigeren ursprünglichen F1-Cut erkennt der Encoder 96,55 % der PowerShell-Base64-Fälle, verursacht dort aber 9,84 % Fehlalarme. Das Modell besitzt also erkennende Signale; sie ergeben noch keine hinreichend robuste Trennung für eine gemeinsame strenge Schwelle.
Zurück zum ursprünglichen Bash-Test
| Modell / Schwellenregel | Treffer | Fehlblocks | Recall | FPR | F1 |
|---|---|---|---|---|---|
| Linear erweitert / strenge explorative Regel | 142/193 | 6/4.001 | 73,6 % | 0,15 % | 83,3 % |
| Chunk-Encoder / gleiche Regel | 130/193 | 1/4.001 | 67,4 % | 0,025 % | 80,2 % |
| Kestrel / veröffentlichte Einzelurteile | 178/193 | 10/4.001 | 92,2 % | 0,25 % | 93,4 % |
Kestrel bleibt auf dieser ursprünglichen Aufgabe stark. Der Encoder erzeugt am gezeigten Cut weniger Fehlalarme, erkennt aber deutlich weniger positive Fälle. Diese Zeilen vergleichen unterschiedliche tatsächlich erreichte FPR und dürfen nicht als Vergleich an exakt demselben Betriebspunkt gelesen werden.
Auch die Erweiterung schützt nicht automatisch die ursprüngliche Leistung: Unser ursprünglicher eigener linearer Bash-Klassifikator erreichte bei seiner Validierungs-F1-Schwelle 92,39 % F1. Das erweiterte Modell kommt bei seiner entsprechenden Schwelle auf 87,77 %, der neue Chunk-Encoder auf 86,09 %. Diese eigenen Bash-Baselines sind von Kestrel zu unterscheiden. Der Transfergewinn geht in diesem Lauf mit einem Rückgang auf dem ursprünglichen Test einher.
Der Kommentar-Padding-Test
Wir stellen denselben zurückgehaltenen POSIX- oder PowerShell-Command hinter 4.096 beziehungsweise 16.384 Bytes wiederholter harmloser Kommentarzeilen. Positive und negative Fälle erhalten identisches Padding. Dieser zusätzliche Test wird weder trainiert noch für Checkpoint, Temperatur oder Schwelle verwendet; die Modelle behalten ihre ursprünglichen Validierungs-F1-Schwellen.
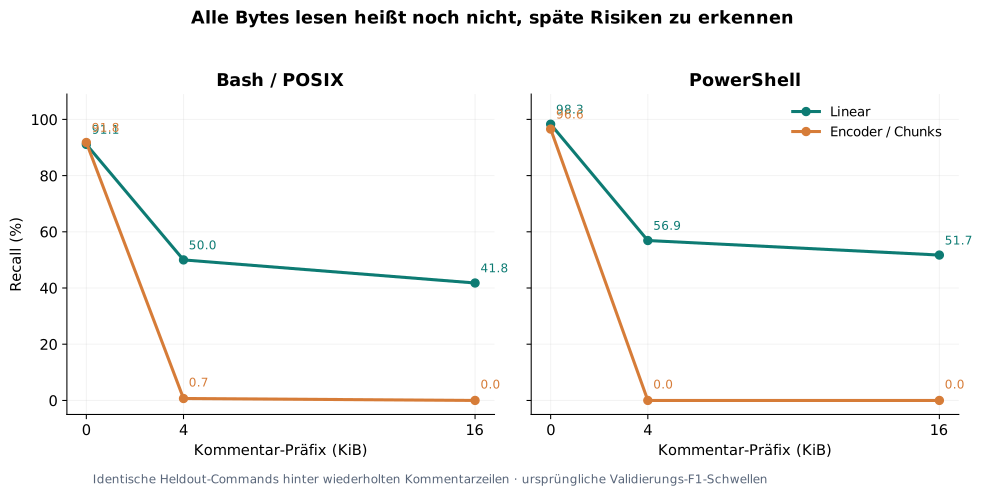
Abbildung 4. Statische Robustheitsdiagnose mit unverändertem Command am Dokumentende. Quelllabels werden vererbt; die Skripte wurden nicht ausgeführt. Die Diagnose gilt für diese konkrete Form wiederholter Kommentar-Präfixe.
Linear fällt bei POSIX von 91,10 % Recall auf 50,00 % hinter 4 KiB und 41,78 % hinter 16 KiB. Bei PowerShell bleiben 56,90 % beziehungsweise 51,72 %. Der Encoder fällt auf 0,68 % POSIX-Recall hinter 4 KiB und ansonsten auf null. Beide Modelle erreichen bei diesen gepaddeten Fällen 100 % beobachtete Spezifität: Sie alarmieren wenig, übersehen aber viele positive Fälle.
Der Encoder hat die entscheidenden Bytes nicht abgeschnitten. Sein Versagen betrifft die Verarbeitung und Aggregation. Beim normalisierten Smooth Max können viele niedrig bewertete Chunks einen einzelnen hohen Chunk-Score absenken; für den Maximalwert z_max gilt z_max − τ log N ≤ S ≤ z_max. Auch ein veränderter Kontext im letzten Chunk und eine vom Training abweichende Kommentarverteilung können beitragen. Welcher Anteil das konkrete Ergebnis verursacht, ist bislang nicht isoliert.
Für Linear ist ein verwandter Effekt plausibel: Wiederholte Zeichenmuster verändern Termfrequenzen und die L2-Normalisierung des Dokumentvektors. Relevante Command-Merkmale erhalten relativ weniger Gewicht. Das ist eine Erklärungshypothese, keine durch eine separate Ablation nachgewiesene Ursache.
7. Fazit: Die Daten gewinnen, die schwierigen Fälle bleiben
Die Experimente sprechen für eine pragmatische Ausgangsbasis: Ein erweiterter linearer Klassifikator ist hier ein sehr starker Ansatz. Mit passenden positiven und negativen Daten über mehrere Shell-Arten kann er den Transfer wesentlich besser bewältigen als das ursprüngliche Kestrel-Modell in unserer erweiterten Auswertung. Der kleine Encoder überholt ihn insgesamt nicht.
Der Encoder-Versuch war trotzdem aufschlussreich. Vollständiges Chunking verbessert lange Skripte deutlich. Gleichzeitig zeigt die strenge gemeinsame Schwelle, dass hohe F1-Werte die Unterschiede zwischen Gruppen verdecken können. Der Padding-Test macht sichtbar, dass vollständige Eingabeabdeckung keine zuverlässige Erkennung isolierter später Risiken garantiert.
Aus diesen Ergebnissen folgt nicht, dass lineare Modelle Bash grundsätzlich besser verstehen oder Encoder für Shell-Risk ungeeignet sind. Wir vergleichen konkrete Modelle, Quellen und einen Trainings-Seed. Trainingsmenge, Optimierung, Labelqualität und Architektur sind nicht vollständig voneinander getrennt. Die kleinen Command-Gruppen und synthetischen Obfuskationen begrenzen die Aussagekraft zusätzlich.
Die nächsten sinnvollen Experimente sollten deshalb konkrete Ursachen isolieren: unveränderte Chunk-Logits mit verschiedenen Aggregationen vergleichen, Kommentare und späte Nutzlasten aus ausschließlich Trainingsdaten variieren und einen neuen, unangetasteten Test aus tatsächlichen Tool-Aufrufen aufbauen. Quellen- und Familien-Splits sowie überprüfte Hard Negatives wären besonders wertvoll. Shell-spezifische Kalibrierung kann helfen, müsste aber vor einer Nutzung auf unabhängigen Daten geprüft werden.
Unser Ergebnis ist kein Sieg einer Architektur. Es ist ein Hinweis darauf, welche Daten und Betriebspunkte ein Shell-Risk-System tatsächlich beherrschen muss.
Quellen und Reproduktion
- Kontext Security: ShellRisk-Bench. Definition der Aufgabe, ursprünglicher Split und veröffentlichte Kestrel-Einzelurteile.
- Kontext Security: Kestrel. Offizielles JSON-Modell und veröffentlichte Prüfsumme. Der am 7. Oktober erneut heruntergeladene Stand ist im Versuchsarchiv dokumentiert.
- Shell Safety. Zusätzliche POSIX-, PowerShell- und CMD-Command-Daten. Quellrevision und Fit-/Validierungs-/Test-Aufteilung sind im Versuchsprotokoll dokumentiert.
- Eigene Experimente: Cross-Shell-Vergleich vom 4. Oktober 2026, Chunk-Encoder-Lauf vom 5. Oktober sowie Schwellenvergleich und gepaarter Padding-Test vom 6. Oktober. Roh-Scores, Quellrevisionen und Daten-Audits liegen in den internen Experimentverzeichnissen und sind hier nicht als öffentliche Downloads verlinkt.
- Die vier Abbildungen wurden aus gespeicherten Ergebnissen erzeugt. Plot-Skript und zugrunde liegende Daten gehören zum Versuchsarchiv. Keine Abbildung zeigt eine neu auf Testdaten optimierte Schwelle.
Grenzen der Untersuchung. Öffentliche Labels sind nicht unabhängig auditiert. Exakte Deduplizierung und Präfixprüfungen beweisen keine Unabhängigkeit von Quellen oder Malware-Familien. Der öffentliche PowerShell-Skriptbestand liefert binäre Quelllabels, keine im Versuch bestätigten Malware-Verdikte. Wir berichten statische Textklassifikation. Kein Dataset-Command und kein Payload wurde ausgeführt.
Alle Zahlen beziehen sich auf die hier beschriebenen Daten und Schwellen. Die Abbildungen stammen aus gespeicherten Ergebnissen, ohne synthetische Leistungswerte.