Wolf Defender im Buried-Injections-Benchmark
Buried Injections untersucht eine konkrete Schwäche bei der Erkennung von Prompt Injection: Angriffe aus AgentDojo werden in längere, realistische Tool-Outputs eingebettet. So lässt sich prüfen, ob ein Detektor eine Injection auch dann erkennt, wenn sie nur einen kleinen Teil eines überwiegend normalen Inhalts ausmacht.
Der Benchmark misst damit Context Dilution, keine Multi-Turn-Angriffe. Diese Unterscheidung ist für die Einordnung der Wolf-Ergebnisse wichtig.
Genau diese Context Dilution ist ein Problem für viele Open-Weight-Detektoren: Isolierte Angriffstexte werden teils gut erkannt, dieselben Texte im vollständigen Tool-Output deutlich seltener. Das zeigen die Payload- und Full-Context-Ergebnisse des Benchmarks.
Wolf Defender auf Buried Injections
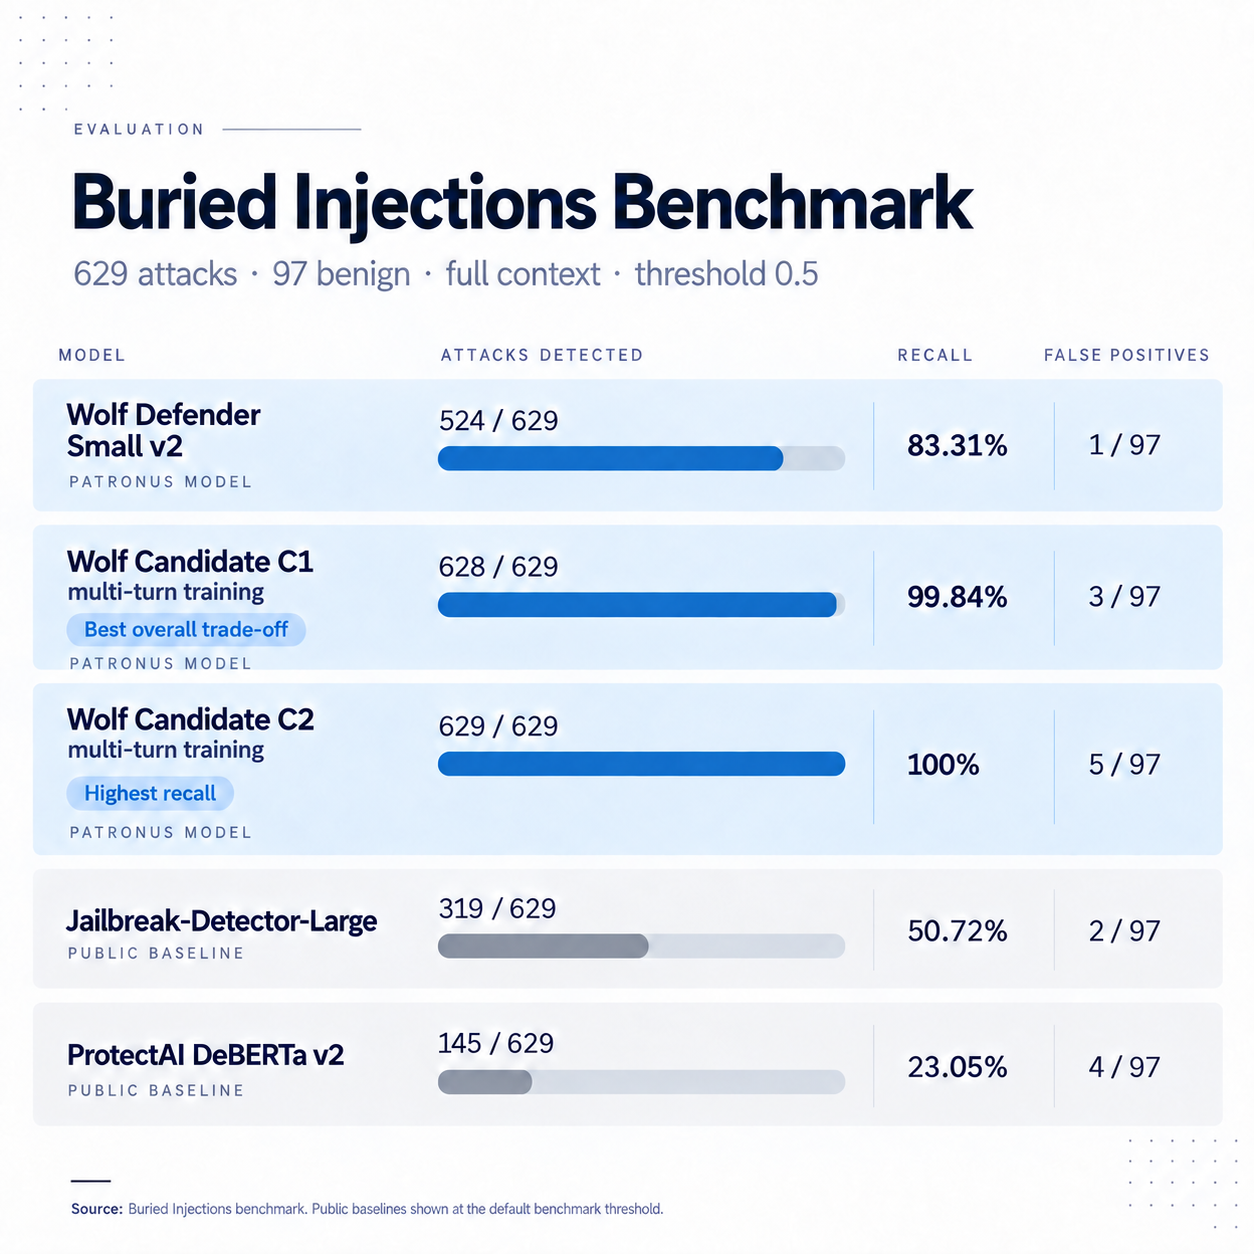
Die Patronus-Runtime verarbeitet große Inhalte in kleinen Chunks statt als einen einzigen riesigen Input. Das aktuelle Wolf Defender Small v2 wurde ausschließlich für Single-Turn Prompt Injection trainiert, ohne explizite Multi-Turn-Memory. Auf den 629 eingebetteten Angriffsfällen erkennt es 524 Angriffe, bei einem Fehlalarm unter 97 harmlosen Fällen.
| Modell | Erkannte Angriffe | Recall | Fehlalarme |
|---|---|---|---|
| Wolf Defender Small v2 | 524 / 629 | 83,31 % | 1 / 97 |
| Wolf Candidate C1 (Multi-Turn-Training, intern) | 628 / 629 | 99,84 % | 3 / 97 |
| Wolf Candidate C2 (Multi-Turn-Training, intern) | 629 / 629 | 100 % | 5 / 97 |
| Jailbreak-Detector-Large | 319 / 629 | 50,72 % | 2 / 97 |
| ProtectAI DeBERTa v2 | 145 / 629 | 23,05 % | 4 / 97 |
Bei den im öffentlichen Benchmark gezeigten Standardeinstellungen ist Jailbreak-Detector-Large der beste veröffentlichte Trade-off: 319 von 629 Angriffen bei zwei Fehlalarmen. Wolf Defender Small v2 liegt bei dieser festen Schwelle von 0,5 deutlich darüber. Die öffentlichen Baselines stammen aus dem Benchmark-Repository; die Wolf-Zahlen aus unserer eigenen Auswertung auf demselben Fallmaterial. Der Repository-Autor zeigt außerdem, dass eine andere Schwellenwertwahl die Rangfolge verändern kann. Die Tabelle ist deshalb ein Vergleich bei den gezeigten Einstellungen, keine allgemeine Rangliste aller möglichen Konfigurationen.
Was die internen Kandidaten zeigen
Die beiden internen Kandidaten der nächsten Wolf-Generation werden zusätzlich auf längere Agent-Verläufe, Tool-Kontext und Angriffe über mehrere Schritte trainiert. Auf Buried Injections erkennen C1 und C2 628 beziehungsweise 629 der 629 Fälle. Das beschreibt ihre Leistung bei eingebetteten Angriffen; es belegt für sich genommen keine Erkennungsrate für Multi-Turn-Angriffe.
Auch die Grenzen des Datensatzes gehören zur Einordnung: Die 629 Fälle verwenden 27 unterschiedliche Angriffspayloads in verschiedenen AgentDojo-Kontexten. Unsere internen Kandidaten haben AgentDojo-inspirierte Trainingsdaten gesehen. Die 97 harmlosen Fälle sind zudem eine kleine Stichprobe für belastbare Aussagen über Fehlalarme im Produktivbetrieb. Weder der perfekte Wert von C2 auf diesem Datensatz noch die anderen Zahlen bedeuten, dass Prompt Injection gelöst ist.
Die Ergebnisse zeigen, warum Erkennung im vollständigen Kontext geprüft werden muss: Das gefährliche Signal kann nur einen kleinen Teil eines viel größeren AI-Kontexts ausmachen. Genau in dieser Situation verlieren mehrere öffentliche Detektoren im Benchmark deutlich an Erkennungsrate.
Wolf Defender Small v2 ist öffentlich verfügbar. Die beiden Kandidaten bleiben intern, bis die nächste Evaluationsrunde abgeschlossen ist. Die Benchmark-Methodik und Rohdaten sind öffentlich; mehr zum Modell steht in unserem Beitrag zu Wolf Defender v2.