Lakera vs. Patronus: Prompt-Injection-Schutz im Vergleich
Wer nach „Lakera vs. Patronus“ oder einer Lakera Alternative für Prompt-Injection-Erkennung sucht, muss zwei Fragen trennen: Wie gut erkennt ein Dienst Angriffe? Und wie häufig blockiert er dabei harmlose Inhalte? Für produktive KI-Anwendungen sind beide Kennzahlen relevant.
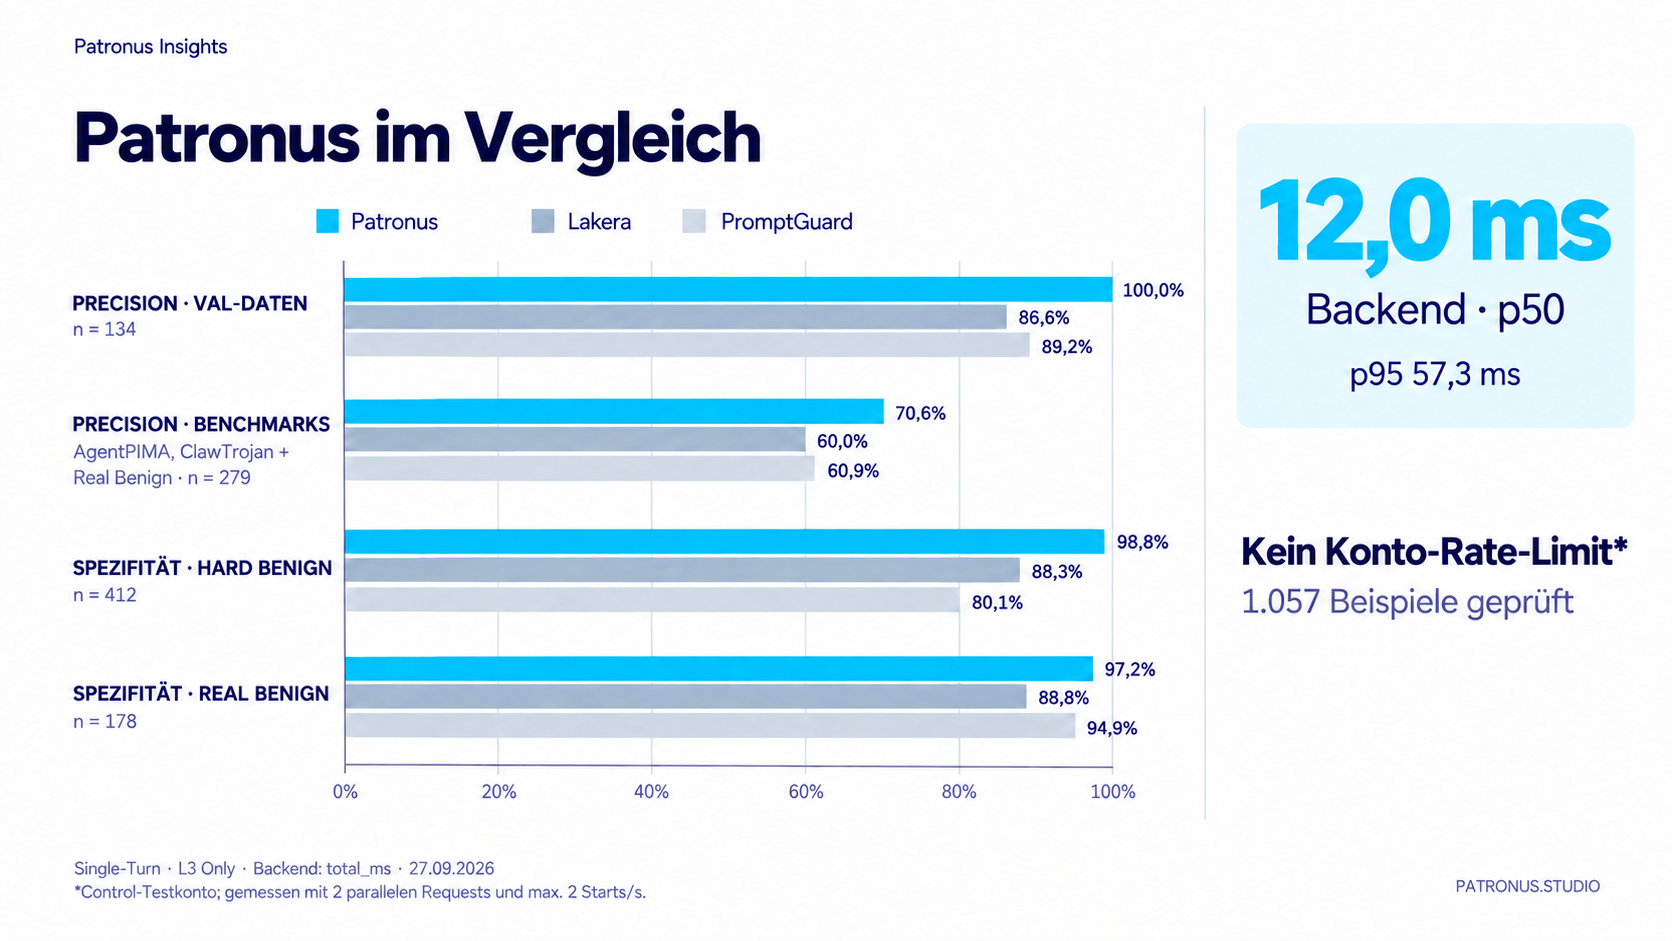
Wir haben die Patronus Control API mit den APIs von Lakera und PromptGuard.co auf 825 identischen Single-Turn-Eingaben verglichen. Patronus erzeugte auf 412 gezielt schwierigen harmlosen Eingaben 5 Fehlalarme, Lakera 48 und PromptGuard 82. Auf einer ausgewählten Gruppe mit AgentPIMA- und ClawTrojan-Texten erkannte Lakera dagegen mehr Angriffe. Der Vergleich zeigt also einen klaren Vorteil bei Fehlalarmen, aber keinen pauschalen Gesamtsieg.
Lakera vs. Patronus: Die Ergebnisse im Überblick
| Messgröße | Patronus | Lakera | PromptGuard.co |
|---|---|---|---|
| Precision, eigene Validation, n = 134 | 100,0 % | 86,6 % | 89,2 % |
| Precision, ausgewählte Benchmarks, n = 279 | 70,6 % | 60,0 % | 60,9 % |
| Spezifität, Hard Benign, n = 412 | 98,8 % | 88,3 % | 80,1 % |
| Spezifität, Real Benign, n = 178 | 97,2 % | 88,8 % | 94,9 % |
Real Benign ist eine Teilmenge der 279 Benchmark-Eingaben. Es ist in der Tabelle zusätzlich ausgewiesen und darf nicht zur Gesamtsumme addiert werden. Insgesamt umfasst der Vergleich 412 Hard-Benign-Eingaben, 279 Benchmark-Eingaben und 134 eigene Validation-Eingaben.
Auf Hard Benign entsprechen die Spezifitätswerte 5 Fehlalarmen bei Patronus, 48 bei Lakera und 82 bei PromptGuard. Gegenüber Lakera sind das in dieser Stichprobe rund 90 Prozent weniger Fehlalarme. Der Real-World-Benign-Datensatz von Rogue Security umfasst 178 legitime Eingaben aus KI-Coding-Workflows. Hier wurden 5, 20 beziehungsweise 9 Eingaben fälschlich als Angriff markiert.
Spezifität beschreibt den Anteil korrekt akzeptierter harmloser Eingaben. Sie sagt allein nichts über die Erkennung von Angriffen aus. Deshalb betrachten wir den Recall getrennt.
Angriffserkennung: Wo Lakera vorn liegt
Auf unseren eigenen Validation-Daten erkannte Patronus 89 von 94 Angriffen, bei 40 von 40 korrekt akzeptierten benignen Fällen. Das ergibt 94,7 Prozent Recall und 100 Prozent Precision. Weil diese Daten von uns stammen, betrachten wir sie getrennt von den externen Benchmark-Texten.
Die ausgewählte Benchmark-Gruppe enthält Rohtexte aus AgentPIMA, ClawTrojan und die 178 Real-Benign-Eingaben. Unter den 279 Fällen sind 89 Angriffe. Lakera erkannte 30 davon (33,7 Prozent), PromptGuard 14 (15,7 Prozent) und Patronus 12 (13,5 Prozent). Beim Recall dieser Angriffe liegt Lakera also vorn. Patronus hatte in der gesamten Gruppe die niedrigste Fehlalarmrate und die höchste Precision.
AgentPIMA und ClawTrojan wurden für mehrstufige Agent-Szenarien entwickelt. In unserem Test haben wir ausgewählte Texte daraus einzeln an die APIs geschickt. Das ist keine Evaluation vollständiger Agentenverläufe. Wolf wurde auf diesen beiden Datensätzen nicht trainiert und erkannte im Einzeltext-Replay keinen der 36 positiven ClawTrojan-Fälle. Dieser Befund gehört zu einer fairen Einordnung der Ergebnisse.
PromptGuard vs. Patronus: Welche Daten wurden verglichen?
Die Zahlen oben beziehen sich auf die API von PromptGuard.co, nicht auf Metas separat benanntes Modell Prompt Guard. Auf denselben 412 Hard-Benign-Eingaben verzeichneten wir bei PromptGuard.co 82 Fehlalarme gegenüber 5 bei Patronus. In der ausgewählten Benchmark-Gruppe erkannte PromptGuard.co 14 von 89 Angriffen gegenüber 12 bei Patronus.
PromptGuard.co veröffentlicht eigene Benchmark-Ergebnisse auf anderen Datensätzen und für seine vollständige Pipeline. Diese Werte sind mit unserem Test nicht direkt vergleichbar. Ebenso wenig lässt sich aus einer Stichprobe ableiten, wie sich eine der APIs auf jedem produktiven Datenverkehr verhält.
So wurde gemessen
Alle drei APIs liefen mit ihren jeweiligen Standard-Schwellenwerten und Standard-Entscheidungsregeln. Die Schwellenwerte wurden nicht auf diese Stichprobe optimiert. Bei Patronus haben wir L3 Only erzwungen: Jede Eingabe ging bis zum Wolf-Modell, ohne dass eine vorgeschaltete L1- oder L2-Schicht früh entscheiden konnte. Verglichen wurde jeweils die Injection-Entscheidung.
Die externen Benchmarks wurden als ausgewählte Stichproben geprüft, nicht als vollständige Suites. Das verfügbare Testvolumen war durch den praktisch nutzbaren Umfang der kostenlosen Zugänge begrenzt. Die Messung erfolgte vom 24. bis 27. September 2026. Modellstände, Konfigurationen und Anbieter-APIs können sich ändern. Diese Daten sind eine Patronus-eigene Vergleichsmessung, keine unabhängige Zertifizierung.
Latenz: Backend-Zeit und HTTP-Zeit getrennt betrachten
Auf 1.057 unterschiedlichen Single-Turn-Eingaben meldete das Patronus-Backend für den erzwungenen L3-Pfad 12,0 ms p50 und 57,3 ms p95 Scan-Laufzeit (total_ms). Der vollständige HTTP-Aufruf dauerte auf diesem Satz 167,8 ms p50 und 427,7 ms p95. Die 12 ms sind daher keine Ende-zu-Ende-Latenz für den Client.
Für die 825 gemeinsamen Eingaben lag die HTTP-Latenz im Median bei 93,3 ms für Lakera, 167,4 ms für Patronus und 21.923,6 ms für PromptGuard.co. Die Anbieter wurden zu unterschiedlichen Zeitpunkten gemessen. Lakera war in diesem Lauf beim vollständigen HTTP-Aufruf schneller als Patronus. Aus den gemessenen PromptGuard-Antwortzeiten lässt sich keine allgemeine Aussage über dessen typische Produktionslatenz oder eine aktive Drosselung ableiten.
Patronus als Lakera Alternative: Wann ist das sinnvoll?
Lakera bietet laut eigener Produktseite eine breitere AI-Security-Plattform für Anwendungen, Agents und Unternehmensnutzung. Patronus ist eine Lakera Alternative, wenn vor allem eine Prompt-Injection-Prüfung mit wenigen Fehlalarmen und die Möglichkeit zum Eigenbetrieb gesucht werden.
Wolf Defender Small ist unter Apache 2.0 als offenes Modell mit ONNX-Varianten verfügbar. Für eine lokale Prüfung braucht es keinen externen Scan-API-Aufruf und kein monatliches API-Kontingent. Die hier gezeigten API-Ergebnisse gelten jedoch für die gehostete Patronus-Konfiguration; sie sind keine erneute Evaluation jeder veröffentlichten, quantisierten Modellvariante.
Die Bildnotiz „Kein Konto-Rate-Limit“ bezieht sich ausschließlich auf das verwendete Control-Testkonto: In diesem Lauf wurden 1.057 Beispiele ohne kontospezifischen Kontingentsstopp verarbeitet. Der Test-Runner begrenzte sich selbst auf zwei parallele Anfragen und höchstens zwei Starts pro Sekunde. Daraus folgt kein Versprechen unbegrenzter Last für andere Konten. Lakera stoppte in diesem Lauf am Free-Kontingent; bei PromptGuard.co wurde keine HTTP-429-Antwort protokolliert.
Fazit
Lakera vs. Patronus ist in dieser Messung vor allem ein Vergleich zwischen Angriffserkennung und Fehlalarmrate. Patronus ließ auf beiden benignen Datengruppen mehr legitime Eingaben passieren und erreichte auf eigener Validation hohe Precision. Lakera erkannte auf den ausgewählten Agent-Benchmark-Texten mehr Angriffe und hatte im gemeinsamen HTTP-Lauf die kürzere Antwortzeit. PromptGuard vs. Patronus zeigt auf derselben Stichprobe ebenfalls einen deutlichen Unterschied bei Fehlalarmen, aber keinen allgemeinen Maßstab für alle Workloads.
Wer die Modelle selbst prüfen möchte, kann mit Wolf Defender Small beginnen oder die Patronus AI-Modelle ansehen. Für den eigenen Datenverkehr bleibt ein Test mit denselben Inputs, Entscheidungsregeln und Betriebsbedingungen der aussagekräftigste Vergleich.
FAQ
Häufige Fragen
Ist Patronus eine Alternative zu Lakera?
Ja, wenn du Prompt-Injection-Erkennung für eigene KI-Anwendungen suchst. Im hier beschriebenen Test verursachte Patronus weniger Fehlalarme auf legitimen Inhalten. Lakera bietet darüber hinaus eine breitere AI-Security-Plattform. Wolf Defender ist zusätzlich als offenes Modell für den lokalen Betrieb verfügbar.
Wer erkennt mehr Angriffe, Lakera oder Patronus?
Das hängt vom Datensatz ab. Auf Patronus-eigenen Validation-Daten erkannte Patronus 89 von 94 Angriffen. Auf der ausgewählten Benchmark-Gruppe mit AgentPIMA und ClawTrojan erkannte Lakera 30 von 89 Angriffen, Patronus 12. Die Datengruppen sollten getrennt betrachtet werden.
Wie schneidet PromptGuard vs. Patronus ab?
Auf den 412 gemeinsamen Hard-Benign-Eingaben löste die getestete PromptGuard.co-API 82 Fehlalarme aus, Patronus 5. Auf der ausgewählten Benchmark-Gruppe erkannte PromptGuard 14 von 89 Angriffen, Patronus 12. Diese Messung betrifft PromptGuard.co und ist nicht mit Metas Prompt Guard gleichzusetzen.
Sind 12 ms die vollständige Patronus-API-Latenz?
Nein. 12,0 ms ist der Median der vom Patronus-Backend gemeldeten Scan-Laufzeit. Der vollständige HTTP-Aufruf lag in derselben Messung bei 167,8 ms im Median. Die Messung erzwang den Wolf-Modellpfad ohne frühe L1- oder L2-Entscheidung.