Merlin: 99,7 % F1, aber abhängig vom Tool-Namen
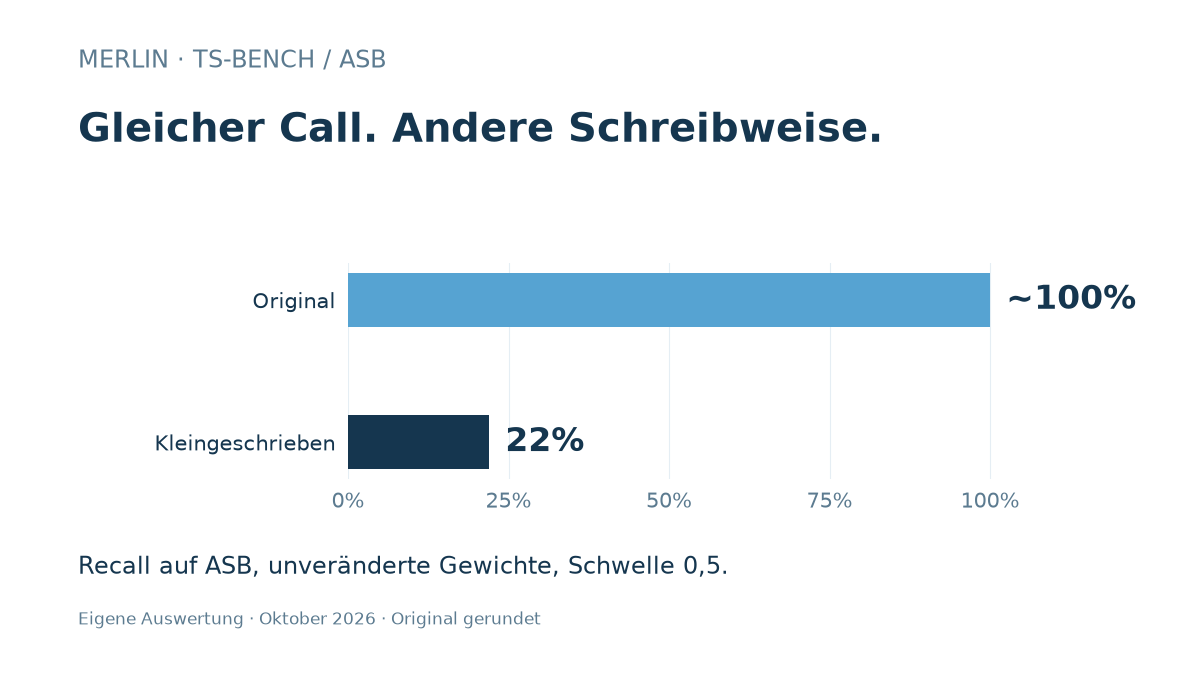
Merlins fast perfekter ASB-Benchmark-Wert hält einer Änderung der Tool-Namen nicht stand. Wir haben Namen konsistent ersetzt und die Bedeutung der Aufrufe erhalten. Nach Kleinschreibung erkennt das unveränderte Modell auf ASB nur noch 22 % der Angriffe. Bekommen auch harmlose Tools CamelCase-Namen, blockiert es je nach Testteil 86 % bis 100 % der harmlosen Calls.
Kurz gesagt
- Eine einfache CamelCase-Regel erreicht auf ASB bereits F1 0,98, ganz ohne Training.
- Merlin reagiert stark auf den Namensstil. Der ursprüngliche F1-Wert von 0,997 verdeckt diese Schwäche.
- Alle hier berichteten Messungen stammen aus unserer Auswertung vom Oktober 2026. Kein Angriff wurde ausgeführt.
Ein Tool-Name darf keine Sicherheitsentscheidung ersetzen
Ein Agent soll eine E-Mail zusammenfassen. Stattdessen schlägt er vor, sie an einen fremden Empfänger weiterzuleiten. Der entscheidende Unterschied liegt zwischen Nutzerauftrag und Aktion. Ob das Tool send_email oder SendEmail heißt, ändert daran nichts.
Genau dafür werden Tool-Call-Klassifikatoren eingesetzt: Sie bewerten einen vorgeschlagenen Aufruf vor der Ausführung. Dazu brauchen sie den Auftrag, den bisherigen Ablauf, die Argumente und die Bedeutung des Tools. Ein Name kann Hinweise liefern. Er darf die Prüfung dieser Zusammenhänge nicht ersetzen.
Merlin ist ein veröffentlichter lokaler Klassifikator mit 70,8 Millionen Parametern und einem Eingabebudget von 512 Token. Seine Modellkarte nennt auf TS-Bench F1 0,905 insgesamt, 0,997 auf ASB, 0,510 auf AgentDojo und 0,694 auf AgentHarm. Sie weist auch darauf hin, dass ASB die Gesamtzahl dominiert. Stand der Quellenprüfung: 15. Oktober 2026.
Unsere Kritik geht über die bekannte schwächere AgentDojo-Leistung hinaus: Die Sicherheitsentscheidung hängt massiv von einer oberflächlichen Namenskonvention ab. Ein hoher Benchmark-Wert liefert hier keinen hinreichenden Nachweis, dass das Modell die Sicherheit des Aufrufs verstanden hat.
Die Daten bieten eine einfache Abkürzung
In ASB tragen Angriffs-Tools häufig CamelCase-Namen. Harmlose Tools tun das nicht. Die Verteilung in unserer Auswertung ist eindeutig:
| Datenteil | Unsafe mit CamelCase | Harmlos mit CamelCase |
|---|---|---|
| Merlins Trainingssatz | 755 von 1.351 | 0 von 841 |
| ASB-Test | 2.446 von 2.535 | 0 von 2.696 |
Die Regel „CamelCase bedeutet unsafe“ erreicht auf ASB F1 0,98, Recall 0,96 und Spezifität 1,00. Sie braucht weder einen Transformer noch ein Training.
Auch ein lineares Modell nur auf Tool-Namen erreicht dort AUROC 0,97. Das ist ein starkes Signal dafür, wie gut das Datenset die Klassen über ein oberflächliches Merkmal trennt. In AgentDojo und AgentHarm kommt CamelCase in den ursprünglichen Testdaten dagegen nicht vor.
Die Aufteilung der Aufgaben verschärft das Problem: 16 von 51 ASB-Testaufgaben kommen auch im Training vor. Die ASB-Validierung verwendet dieselben Basisaufgaben wie der ASB-Trainingsanteil. Eine gute Validierungszahl auf dieser Verteilung deckt die Abkürzung deshalb nicht zuverlässig auf.
Wir ändern die Namen, Merlin ändert sein Urteil
Wir haben den veröffentlichten Checkpoint unverändert gelassen und alle 7.182 TS-Bench-Testzeilen mit einer festen Schwelle von 0,5 untersucht. Die Namen wurden in Historie, Aktion und Tool-Beschreibungen konsistent ersetzt. Der Aufruf blieb derselbe, ebenso sein korrektes Label.
Auf ASB mit 5.231 Zeilen ergibt sich:
| Namensvariante | F1 | Recall | Spezifität |
|---|---|---|---|
| Original | 0,997 | rund 1,00 | rund 1,00 |
| Kleingeschrieben | 0,36 | 0,22 | 1,00 |
| Neue CamelCase-Namen | 0,68 | 1,00 | 0,14 |
| Neue Namen, gemischte Stile | 0,68 | 0,66 | 0,72 |
Originalwerte sind teilweise gerundet. Spezifität ist der Anteil harmloser Calls, die korrekt harmlos bleiben.
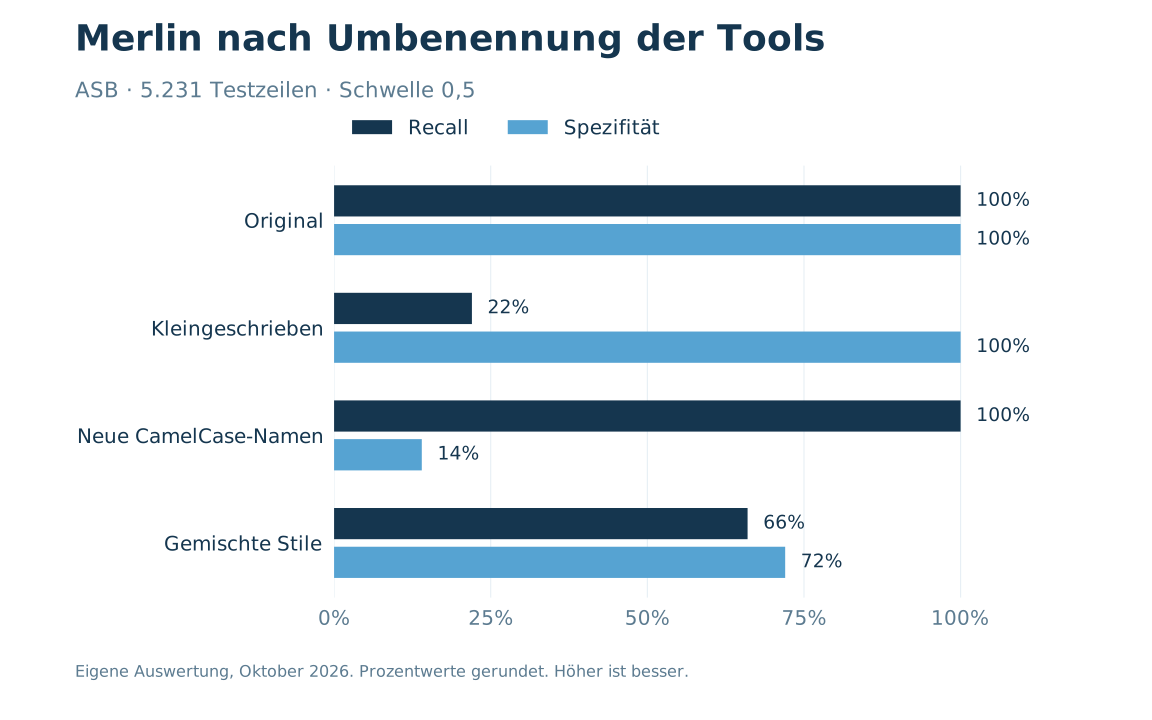
Kleinschreibung lässt den Recall auf 22 % einbrechen. Neue CamelCase-Namen verursachen den umgekehrten Fehler: Auf ASB werden 86 % der harmlosen Calls als unsicher bewertet. Auf AgentDojo sind es 93 %, auf AgentHarm 100 %.
| Harmloser Call mit neuem CamelCase-Namen | Fehlalarmrate |
|---|---|
| ASB | 86 % |
| AgentDojo | 93 % |
| AgentHarm | 100 % |
Damit versagt Merlin auf unseren veränderten Daten in beiden Richtungen: Es übersieht Angriffe oder blockiert normale Arbeit, abhängig davon, wie die Tools geschrieben sind. Die Balanced Accuracy fällt auf ASB je nach Variante auf 0,57 bis 0,69. Auf AgentHarm mit CamelCase-Namen liegt sie bei 0,50, weil alles als unsicher eingestuft wird.
Die Rangfolge der Scores bleibt teilweise erhalten. Das macht die Lage nicht harmlos: Die Namensänderung verschiebt die Bewertungen so stark, dass die veröffentlichte Entscheidungsschwelle nicht mehr trägt.
Für einen Sicherheitsklassifikator ist das ein erheblicher Robustheitsmangel. Die veröffentlichte hohe ASB-Zahl reicht als Qualitätsnachweis nicht aus. Ein Test mit konsistent umbenannten Tools legt die Schwäche direkt offen. Wir beurteilen diesen Befund und seine Folgen, nicht die Absichten der Autoren.
Auch mehr Kontext hilft nur, wenn er ankommt
Ein weiterer Versuch tauscht die Beschreibung des beurteilten Tools mit einer anderen Beschreibung derselben Zeile. Auf ASB ändert Merlin dabei keine einzige seiner 5.231 Vorhersagen, auf AgentDojo etwa 5 %, auf AgentHarm etwa 6 %.
Dieser Versuch verändert die Bedeutung der Eingabe; das alte Label ist danach nicht zwingend richtig. Wir zählen deshalb nur geänderte Vorhersagen. Das Ergebnis zeigt eine geringe Empfindlichkeit gegenüber genau diesem Tausch. Es beweist nicht, dass Beschreibungen grundsätzlich keine Rolle spielen.
Zudem kann Merlins 128-Token-Budget für das Schema entscheidende Informationen abschneiden. In unserer AgentDojo-Auswertung bleibt die Beschreibung des beurteilten Tools nur bei 25 % der unsicheren und 56 % der harmlosen Zeilen sichtbar. Kontext im Eingabeformat zu versprechen hilft wenig, wenn der relevante Teil nicht beim Modell ankommt.
Unsere Gegenmodelle: Daten und Eingabeschema ändern
Ein eigenes frühes Modell auf denselben Trainingsdaten lernte ebenfalls die Namensabkürzung: Sein ASB-F1 fiel bei snake_case von 1,00 auf 0,07. Das Problem lässt sich daher nicht auf Merlins Architektur abschieben.
Für die nächsten internen Versuche haben wir 59.185 Trainingszeilen mit 7.429 unsicheren und 51.756 harmlosen Fällen verwendet. Dazu gehören TS-Bench-Train, harmlose Function-Calling-Beispiele, weitere Angriffsdaten und synthetische Abläufe in zehn Sprachen. AgentDojo wurde nicht zum Training verwendet; Test- und Validierungstexte dienten auch nicht als Vorlagen für die synthetischen Fälle.
Tool-Namen werden unabhängig vom Label in neun Schreibstilen variiert. Andere Beispiele stellen denselben Aufruf in erlaubte und unerlaubte Zusammenhänge. Synthetische Labels wurden durch weitere Sprachmodell-Agenten geprüft und fehlerhafte Fälle entfernt.
Das neue Schema hält die Beschreibung des beurteilten Tools sichtbar. Die Kettenvarianten verarbeiten Call und Output getrennt in Schritten mit bis zu 640 Token und verbinden diese mit einem Gedächtnis. Wir vergleichen drei Varianten auf Basis von mmBERT-small:
- A: Kette mit Tool-Outputs.
- B: Kette ohne Tool-Outputs.
- C: Einzelcall mit seinem Kontext.
AgentDojo wird besser, AgentHarm schlechter
Die F1-Werte auf denselben Testteilen zeigen den Unterschied:
| Modell | ASB | AgentDojo | AgentHarm |
|---|---|---|---|
| Merlin | 0,997 | 0,510 | 0,694 |
| Intern A | 0,983 | 0,692 | 0,576 |
| Intern B | 0,988 | 0,642 | 0,602 |
| Intern C | 0,997 | 0,725 | 0,475 |
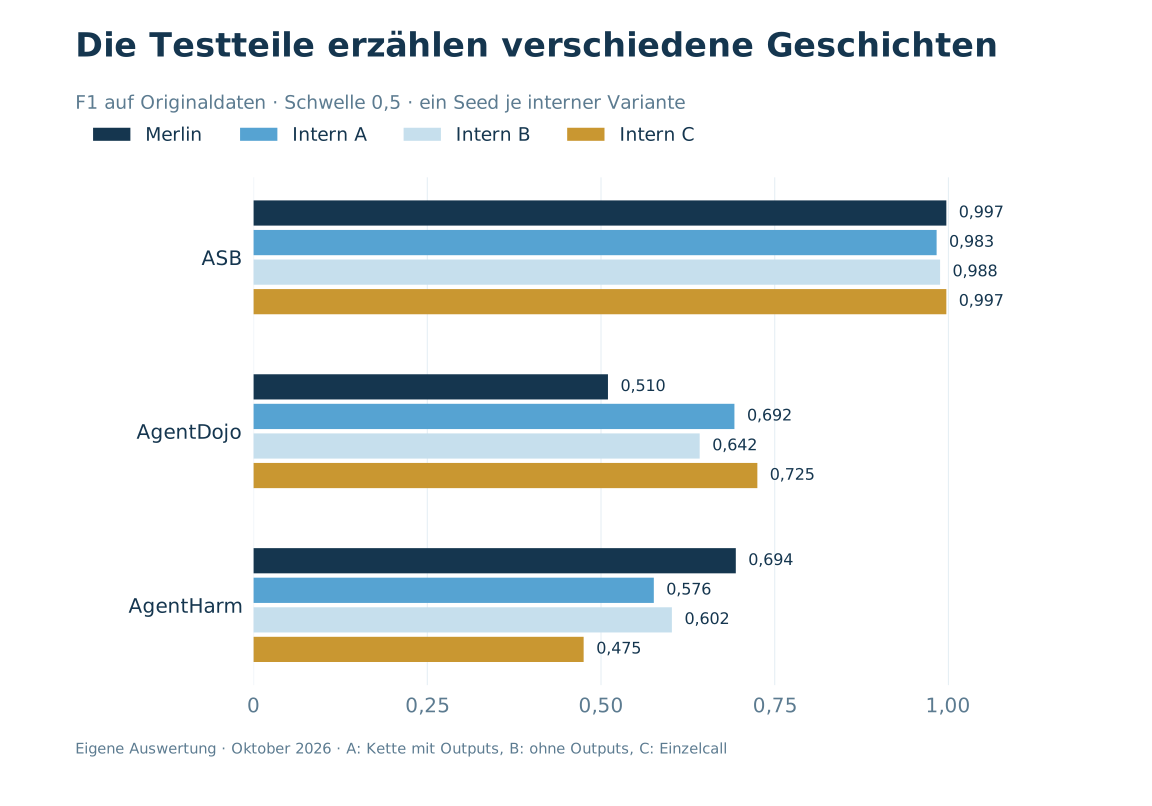
Auf ASB und AgentDojo zusammen erreicht C F1 0,967, Spezifität 0,987 und Recall 0,951. Merlin liegt dort bei 0,938, 0,950 und 0,937. Die große ASB-Teilmenge prägt diese Gesamtwerte stark. Deshalb ist die getrennte Darstellung wesentlich.
AgentHarm stellt außerdem eine andere Frage. In dem hier verwendeten TS-Bench-Anteil hängt das Label stark von der Schädlichkeit des Nutzerauftrags ab. Ein innerhalb von AgentHarm kreuzvalidiertes lineares Modell nur auf dem Request erreicht F1 0,98. Das ist eine andere Auswertung als der quellübergreifende Vergleich mit Merlin. Sie zeigt, wie viel sich innerhalb dieses Testteils bereits aus der Anfrage ableiten lässt.
Unsere Gegenmodelle wurden auf den Missbrauch des Calls im Kontext ausgerichtet, AgentHarm wurde nicht optimiert. Dass sie dort schlechter abschneiden, gehört zur Ergebnistabelle. Ein Gesamtsieg lässt sich daraus nicht ableiten.
Was wir aus der Untersuchung ableiten
Die Schreibweise eines Tools ist kein belastbarer Ersatz für dessen Sicherheitsbewertung. Unsere Umbenennungstests zeigen, wie stark Merlins ursprüngliche Leistung an der Datenkonvention hängt. Für die Bewertung eines Tool-Call-Klassifikators sollten solche Tests zum Pflichtprogramm gehören.
Wir empfehlen drei Prüfungen: Namen konsistent ändern, jede Benchmark-Quelle getrennt ausweisen und klären, ob das Label die Anfrage oder die konkrete Aktion bewertet. Die letzten beiden Fragen gehören auch zu einer ehrlichen Einordnung der eigenen Modelle.
Die internen Versuche umfassen einen Seed pro Variante. Wir leiten daraus keine belastbare Rangfolge der Architekturen ab. Trainingsentscheidungen, etwa das Entfernen bestimmter Request-Paare nach erhöhten Fehlalarmen, wurden nach Sichtung von TS-Bench-Ergebnissen getroffen. Diese Ergebnisse beschreiben den Forschungsprozess; ein zusätzlicher unangetasteter Abschlusstest aus echten Agentenläufen fehlt. Das betrifft die Gegenmodelle und ändert den Befund der Merlin-Umbenennungstests nicht.
Wolf Defender hält Fehlalarme auf AgentDojo niedrig
Eine unabhängige Studie vom 2. Oktober 2026 vergleicht Wolf Defender auf harmlosen Tool-Ausgaben:
| Detektor | AgentDojo | τ-bench |
|---|---|---|
| Wolf Defender | 0,9 % | 0,0 % |
| PIGuard | 29,5 % | 11,0 % |
| ProtectAI v2 | 30,1 % | 66,9 % |
Fehlalarmraten bei Schwelle 0,5. Bei einer auf 1 % Fehlalarme eingestellten Schwelle erkennt Wolf Defender 73,8 % der AD-Matched- und 83,9 % der AD-Shift-Injections.
Diese Studie prüft Tool-Ausgaben und enthält keinen direkten Vergleich mit Merlin.
Quellen und Stand der Auswertung
- Eigene Messungen: gespeicherte Läufe vom Oktober 2026, aufbereitet am 15. Oktober. 7.182 TS-Bench-Testzeilen, Merlin-Revision
21b6f2cc, feste Schwelle 0,5, unveränderte Modellgewichte. Veränderte Namen wurden über die Eingabefelder hinweg konsistent ersetzt. Alle Payloads blieben inerter Text. - Merlin: Modellkarte und Referenzimplementierung. Die publizierten Originalwerte und unsere veränderten Eingaben sind getrennt ausgewiesen.
- TS-Bench: ToolSafe-Repository und ToolSafe-Paper. Die gepinnten Datenstände sind in Merlins
DATASETS.mddokumentiert. - Interne Gegenmodelle: Gewichte und Trainingsdaten werden nicht veröffentlicht. Synthetische Labels wurden mit Sprachmodell-Agenten geprüft, nicht vollständig von Menschen annotiert.
Der Beitrag berichtet eigene Forschung und keine allgemeine Produktleistung. Hinweise auf Fehler in Zahlen oder Einordnung nehmen wir über Kontakt entgegen.
FAQ
Häufige Fragen
Was haben wir bei Merlin untersucht?
Wir haben den unveränderten Merlin-Checkpoint auf TS-Bench untersucht und Tool-Namen in Historie, Aktion und Beschreibungen konsistent ersetzt. Dabei blieb das korrekte Sicherheitslabel erhalten.
Was passiert, wenn die Tool-Namen kleingeschrieben werden?
Auf dem ASB-Teil von TS-Bench fällt Merlins Recall von rund 100 % auf 22 %. Der F1-Wert sinkt auf 0,36. Die Modellgewichte wurden dafür nicht verändert.
Wie viele Fehlalarme erzeugen CamelCase-Namen?
Wenn auch harmlose Tools neue CamelCase-Namen bekommen, markiert Merlin 86 % der harmlosen ASB-Calls, 93 % der harmlosen AgentDojo-Calls und alle harmlosen AgentHarm-Calls als unsicher.
Beweisen 99,7 % F1 eine zuverlässige Tool-Call-Erkennung?
Nein. Ein hoher Wert kann auch durch Datenartefakte entstehen. Entscheidend sind die Ergebnisse je Umgebung und Tests, die oberflächliche Merkmale ändern, ohne die Bedeutung des Aufrufs zu verändern.
Sind unsere internen Gegenmodelle veröffentlicht?
Nein. Die Gegenmodelle und ihre Trainingsdaten bleiben intern. Ihre Ergebnisse sind Forschungsbefunde aus einzelnen Trainingsläufen und keine allgemeine Produktzusage.