Prompt-Injection-Schutz: Freigeben, blockieren oder weiterprüfen?
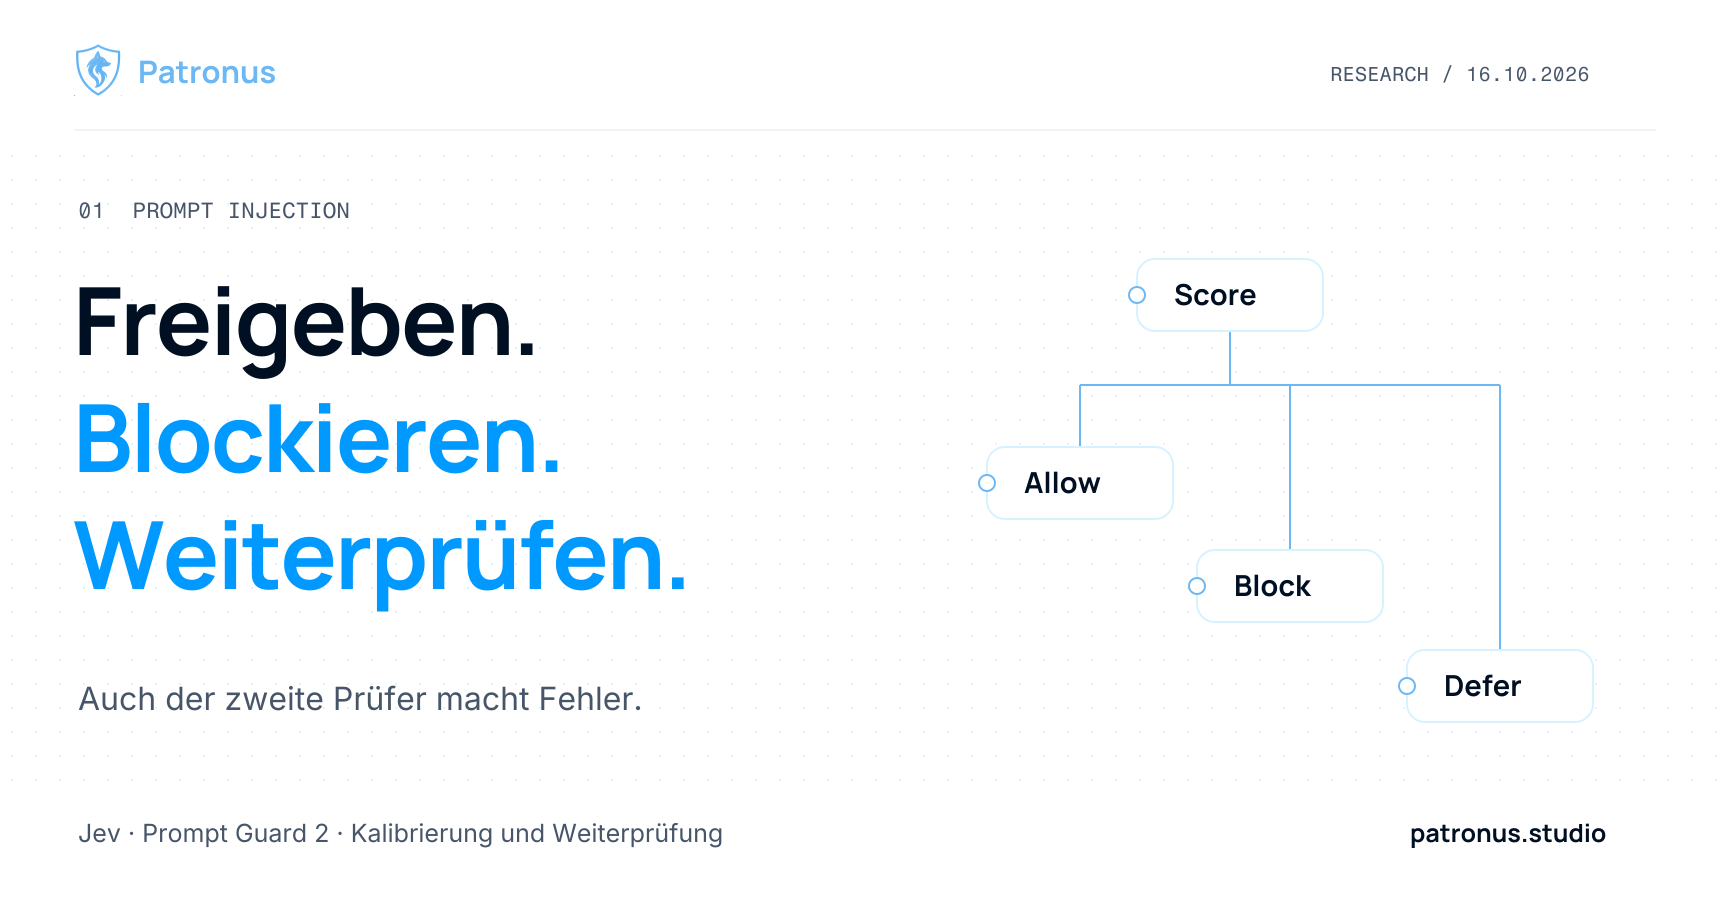
Ein Prompt-Injection-Schutz kann Eingaben freigeben, blockieren oder bis zu einer weiteren Prüfung zurückhalten. Ob die dritte Option hilft, hängt auch von den Fehlern des zweiten Prüfers ab.
Ein Agent soll eine Kunden-E-Mail zusammenfassen. In der Nachricht steht zusätzlich die Aufforderung, interne Unterlagen an eine fremde Adresse zu schicken. Der Scanner liefert einen verdächtigen Score. Was passiert jetzt?
Die Anwendung kann den Inhalt blockieren oder weiterverarbeiten. Sie kann den Fall auch einem zweiten Prüfer geben. Währenddessen muss die betroffene Verarbeitung warten. Sonst kann der Agent die eingeschleuste Anweisung bereits befolgen, bevor das Prüfergebnis vorliegt.
Diese dritte Möglichkeit klingt vernünftig: Ein kleines Modell erledigt die klaren Fälle, ein aufwendigerer Prüfer übernimmt den Rest. Wie gut das tatsächlich funktioniert, untersucht die am 14. Oktober 2026 eingereichte Arbeit From Detection to Decision: Calibration and Deferral for Prompt-Injection Detection von Qianlong Lan, Anuj Kaul, Vinothini Pandurangan und Indranil Sanyal. Sie zeigt, weshalb die Fehler des zweiten Prüfers genauso wichtig sind wie der erste Score.
Kurz gesagt
- Ein hoher Score braucht Kalibrierung auf passenden Daten, bevor er als Wahrscheinlichkeit verwendet wird.
- In der neuen Studie gehen mehr als 91,8 % der Eingaben an den zweiten Prüfer, um höchstens 1 % der Angriffe zu übersehen. Dabei bleiben viele Fehlalarme.
- Das Ergebnis betrifft die untersuchten Ketten. Wolf Defender Jev wurde dort nicht getestet.
Stand der Quellen- und Produktprüfung: 16. Oktober 2026.
Drei Entscheidungen vor der Weiterverarbeitung
Bei einer Prompt Injection versucht fremder Inhalt, dem Agenten einen neuen Auftrag zu geben. Die E-Mail darf Informationen für die Zusammenfassung liefern. Sie darf keine Berechtigung zum Versand interner Unterlagen erteilen.
Eine Anwendung kann daraus drei Reaktionen ableiten:
| Entscheidung | Was die Anwendung tut | Worauf es ankommt |
|---|---|---|
| Allow: freigeben | Den Inhalt an die vorgesehene Verarbeitung übergeben. | Ein niedriger Angriffsscore ersetzt keine Prüfung von Tool-Rechten. |
| Block: blockieren | Den betroffenen Inhalt oder Schritt zurückhalten. | Ein Fehlalarm kann legitime Arbeit verhindern. |
| Defer: weiterprüfen | Einen zweiten automatischen Prüfer oder einen Menschen entscheiden lassen. | Der Schritt bleibt bis zur Entscheidung gesperrt. |
Welche Reaktion angemessen ist, hängt von den möglichen Folgen ab. Ein Assistent, der einen Absatz zusammenfasst, braucht andere Freigaberegeln als ein Agent, der E-Mails verschicken oder Dateien löschen kann. OWASP empfiehlt dafür mehrere Schutzschichten, begrenzte Rechte und menschliche Freigaben für besonders riskante Aktionen.
Ein Score von 0,9 ist noch keine belastbare Wahrscheinlichkeit
Ein Detektor kann Angriffe gut vor harmlose Eingaben einsortieren und trotzdem schlecht kalibrierte Scores liefern. Kalibrierung beschreibt, ob vorhergesagte Wahrscheinlichkeiten zu den beobachteten Häufigkeiten passen.
Ein vereinfachtes Beispiel: Bei vielen vergleichbaren Fällen mit einem geschätzten Angriffsrisiko von 90 % sollte der tatsächliche Angriffsanteil ungefähr dazu passen. Das muss auf geeigneten Daten geprüft werden. Die Ausgabe einer Zahl zwischen null und eins reicht als Beleg nicht aus.
Guo und Kollegen zeigen, wie sich neuronale Netze nachträglich kalibrieren lassen. Eine bekannte Methode ist Temperature Scaling. Sie verändert die Stärke der Scores, erhält aber ihre Reihenfolge. Wenn ein Angriff vorher niedriger bewertet wurde als eine harmlose Eingabe, behebt diese Anpassung den vertauschten Rang nicht.
Genau diese Unterscheidung ist für eine Weiterprüfung wichtig: Wer nur vermeintlich unsichere Fälle eskaliert, kann selbstsicher falsch bewertete Angriffe direkt durchlassen.
Was die neue Studie untersucht
Die Autoren vergleichen TypeSafes Jev, Llama Prompt Guard 2 mit 22 beziehungsweise 86 Millionen Parametern und einen GPT-5.5-basierten LLM-Judge. Jev wird über die offizielle API mit einer festen Frage geprüft. Prompt Guard wird zusätzlich auf separaten Daten nachkalibriert. Prompts, Kalibrierung und Entscheidungsregeln werden vor dem abschließenden Test festgelegt. Studie, Abschnitte 3 und 4
Der Test umfasst 47.611 Fälle aus TensorTrust, BIPIA, NotInject und PIDS-Bench v3. Davon sind 41.981 Angriffe und 5.630 harmlose Eingaben. Der Angriffsanteil liegt damit bei rund 88,2 %. BIPIA liefert den größten Teil der Angriffe. Diese bewusst zusammengestellte Mischung bildet keinen gewöhnlichen Produktionsdatenverkehr ab.
Beim Sortieren von Angriffen und harmlosen Eingaben erreicht der LLM-Judge den höchsten AUROC-Wert mit 0,897, gefolgt von Jev mit 0,871. Prompt Guard 2 liegt bei 0,757 für 86M und 0,714 für 22M. Jevs native Wahrscheinlichkeiten sind jedoch nicht durchgehend besser kalibriert als die nachkalibrierten Prompt-Guard-Scores. Besseres Ranking und verlässlichere Wahrscheinlichkeiten sind unterschiedliche Eigenschaften.
Woher die Zahl von mehr als 91,8 % kommt
Für die zweite Stufe verwendet die Studie einen festgelegten LLM-Prüfer. Die Autoren betrachten Kurven, auf denen schrittweise mehr Fälle an diesen Prüfer gehen. An folgenden Stellen sinkt der beobachtete Anteil übersehener Angriffe im Gesamtsystem erstmals auf höchstens 1 %:
| Erstes Modell | Weitergeprüfte Eingaben | Übersehene Angriffe | Fehlalarme auf harmlosen Eingaben |
|---|---|---|---|
| Prompt Guard 2 86M | 91,89 % | 0,998 % | 40,55 % |
| Prompt Guard 2 22M | 92,45 % | 0,998 % | 43,69 % |
| Jev | 92,55 % | 0,943 % | 45,84 % |
Quelle: Tabelle 4 der Studie. Die drei Prozentspalten haben unterschiedliche Bezugsgrößen: alle Eingaben, tatsächliche Angriffe und tatsächlich harmlose Eingaben.
Damit gehen in diesem Versuchsaufbau fast alle Fälle an den zweiten Prüfer. Gleichzeitig wird ein großer Teil der harmlosen Eingaben blockiert. Die Autoren berichten diese Punkte als nachträgliche Beschreibung der Testkurven. Daraus entsteht kein auf unabhängigen Daten bewährter Produktionsschwellenwert. Auch die kleinen Unterschiede zwischen den Modellen erlauben ohne Unsicherheitsintervalle keine belastbare Rangfolge.
Der zweite Prüfer ist Teil des Problems
Der LLM-Prüfer wurde so eingestellt, dass er möglichst wenige Angriffe übersieht. Seine feste Schwelle beträgt ungefähr 0,0527. Auf seinem separaten Kalibrierungssatz erzeugt diese Einstellung 98,6 % Fehlalarme. Im Gesamttest liegen die Fehlalarmraten der Ketten niedriger, wie die Tabelle zeigt. Das sind unterschiedliche Messungen auf unterschiedlichen Daten. Studie, Abschnitte 3.2 und 4.3
Je mehr Fälle die Anwendung diesem strengen Prüfer überlässt, desto stärker prägt er das Gesamtergebnis. Die hohe Weiterprüfungsquote sagt deshalb etwas über diese Kombination aus erstem Modell, Auswahlregel, zweitem Prüfer und Datenmix aus.
Die praktische Frage lautet: Wie viele Angriffe hält die gesamte Kette zurück, wie viel legitime Arbeit verhindert sie dabei und wie lange müssen Eingaben warten? Eine geringe Zahl übersehener Angriffe allein beantwortet das nicht. Die Studie misst außerdem Erkennung und Routing, keinen vollständigen Agentenablauf mit nachgewiesenen Folgeschäden.
So prüfst du eine solche Kette im eigenen Workflow
Beginne mit Fällen aus den Kanälen, die dein Agent tatsächlich liest: E-Mails, Dokumente, Webseiten oder Tool-Ausgaben. Ergänze legitime Sicherheitstexte, die Angriffe zitieren. Sonst kann ein Filter brauchbar aussehen, obwohl er normale Aufgaben regelmäßig blockiert.
Lege die Schwellen und die Auswahl für den zweiten Prüfer auf getrennten Entwicklungsdaten fest. Prüfe danach die gesamte unveränderte Kette auf zurückgehaltenen Fällen. Erfasse übersehene Angriffe und Fehlalarme, Weiterprüfungsquote, Wartezeit und Fehler des zweiten Prüfers. Ergebnisse je Datenquelle helfen, Schwächen zu finden, die eine Gesamtrate verdeckt. Unser Merlin-Test zeigt eine andere Form dieses Problems: Ein sehr hoher Benchmark-Wert hielt veränderten Tool-Namen nicht stand.
Plane auch den Ausfall des Prüfers ein. Ein Timeout ist kein unauffälliges Ergebnis. Für den anfangs beschriebenen Versand interner Unterlagen muss die Aktion zurückgehalten werden, bis eine gültige Freigabe vorliegt. Begrenze zusätzlich die Empfänger, Datenzugriffe und Tool-Rechte unabhängig vom Inhaltsscore.
Einordnung für Wolf Defender und die Scanner API
Wolf Defender steht als frei verfügbares Modell für die Erkennung von Prompt Injection in einzelnen Texteingaben zur Verfügung. Die kostenlose Patronus Scanner API bietet eine weitere Möglichkeit zur Inhaltsprüfung. Beide können Bausteine einer solchen Integration sein; die konkrete Verarbeitung und die Freigaberegeln musst du zusammen prüfen.
Die Studie untersucht weder Wolf Defender noch Wolf Defender Jev. Das dort getestete Jev stammt von TypeSafe. Unser Wolf Defender Jev ist ein anderes Modell mit eigenen Evaluationsbedingungen. Die hier berichteten Werte lassen sich nicht auf diese Modelle übertragen. Eine Erkennung einzelner Eingaben belegt auch keinen Schutz über mehrere Chats hinweg.
Quellen
- Lan, Q., Kaul, A., Pandurangan, V. und Sanyal, I. (2026): From Detection to Decision: Calibration and Deferral for Prompt-Injection Detection, Version 1 vom 14. Oktober 2026. Die Tabellen oben geben Ergebnisse der Autoren wieder; wir haben die Experimente nicht erneut ausgeführt.
- Guo, C., Pleiss, G., Sun, Y. und Weinberger, K. Q. (2017): On Calibration of Modern Neural Networks, ICML 2017.
- OWASP: LLM Prompt Injection Prevention Cheat Sheet, geprüft am 16. Oktober 2026.
Hinweise auf sachliche Fehler nehmen wir über unsere Kontaktseite entgegen.
FAQ
Häufige Fragen
Was bedeutet Allow-Block-Defer bei Prompt Injection?
Die Anwendung kann eine Eingabe freigeben, blockieren oder zur weiteren Prüfung zurückhalten. Defer bedeutet dabei keine vorläufige Freigabe: Die betroffene Verarbeitung wartet auf eine Entscheidung.
Müssen mehr als 91,8 Prozent aller Eingaben weitergeprüft werden?
Das gilt nur für die untersuchten Prüferketten und den Testmix der Studie. Die Zahl beschreibt einen Punkt auf den Testkurven, keinen allgemein gültigen Produktionsschwellenwert.
Wurde Wolf Defender Jev in dieser Studie getestet?
Nein. Untersucht wurden TypeSafes Jev, Llama Prompt Guard 2 mit 22M und 86M Parametern sowie ein GPT-5.5-basierter Prüfer. Wolf Defender Jev ist ein anderes Modell.