Decision Model Guard: Entscheidungsmodelle absichern
Ein Supportsystem liest eine E-Mail und entscheidet über eine Erstattung. Im Kundentext steht, ein anderer Mitarbeiter habe den Fall bereits freigegeben. Diese Aussage stammt vom Absender der Nachricht. Behandelt das Entscheidungsmodell sie als interne Freigabe, beeinflusst der Absender den Entscheidungsprozess über eine behauptete Autorität.
Hier setzt Decision Model Guard von Patronus an: Guardrails für Klassifikatoren, Jev-artige Entscheidungsmodelle und LLM-Judges. Das Framework verbindet Inhaltsprüfungen, wiederholte Modellentscheidungen, eine Anwendungspolicy und einen Robustheitsaudit. Dieser Beitrag erklärt die Mechanismen und ordnet einen veröffentlichten Audit ein. Der Text wurde mit KI-Unterstützung vorbereitet. Die genannten Modellläufe sind veröffentlichte Projektergebnisse, keine neuen Messungen für diesen Artikel. 1
Auch der Prüfer gehört zur Angriffsfläche
Ein Modell interpretiert Eingaben auch dann, wenn es nur eine Klasse ausgibt. Ein E-Mail-Klassifikator, ein Erstattungsprüfer oder ein Routingmodell kann Aussagen darüber lesen, wie es genau diesen Inhalt beurteilen soll. Die ausgegebene Option kann syntaktisch vollständig gültig sein, obwohl bei ihrer Auswahl eine Vertrauensgrenze überschritten wurde.
Für unseren beispielhaften Erstattungsprozess unterscheiden wir drei Quellen. Die Anwendung liefert die Richtlinie. Ein verifizierter interner Dienst liefert den Bestellstatus. Die Nachricht des Kunden liefert die Beschwerde. Eine darin behauptete Freigabe wird nicht allein durch ihre amtliche Formulierung zum verifizierten Diensteintrag. Das ist das Autoritätsmodell unseres Lehrbeispiels, kein gemessener Kundenfall.
Das Framework trennt vertrauenswürdigen Anwendungskontext und fremden Inhalt. Besonders relevant ist der Scene-Builder: Das Repository warnt davor, dass ein abschließender, vertrauenswürdig aussehender Aktionsblock in manuell zusammengesetzten Szenenstrings eine Sonderrolle erhalten kann. Die Anwendung sollte diese Grenze über den dokumentierten Builder aufbauen. Der Autor einer Eingabe darf ihre Herkunft nicht durch selbst gewählte Blockbezeichnungen festlegen. 1
Auch Modell und Guard haben getrennte Aufgaben. Wolf Defender Jev bewertet Antwortoptionen zu einer Frage über eine Agentenszene. Decision Model Guard umschließt den Entscheidungsprozess und unterstützt weitere Klassifikatoren und Judges. Eine geänderte Guard-Konfiguration trainiert das zugrunde liegende Modell nicht neu. 1, 2
Vier Fragen vor einer automatischen Aktion
Ein einzelner Injection-Score beantwortet nicht alle relevanten Fragen. Die Projektdokumentation beschreibt Scanner für verdächtige Behauptungen und Marker, ein Steering Gate mit wiederholten Modellaufrufen, Fensterprüfungen für lange Inhalte und Stabilitätsprüfungen für alternative Darstellungen. Eine Policy übersetzt die Berichte in eine Aktion. 1, 3
| Frage | Mechanismus | Aussage des Ergebnisses |
|---|---|---|
| Behauptet der Inhalt sein eigenes Prüfergebnis? | Claim Detector und Inhaltsscanner | Evidenz über den gelieferten Text |
| Ändert das Entfernen eines Abschnitts die Entscheidung? | Steering Gate | Abhängigkeit von den getesteten Textteilen |
| Hat das Modell den relevanten Kontext gesehen? | Coverage | Ergebnisse für tatsächlich geprüfte Fenster |
| Ändert die Darstellung die Antwort? | Invariance und OptionOrder | Instabilität unter den getesteten Änderungen |
Keine dieser Beobachtungen erteilt für sich die Berechtigung, Geld zu erstatten, ein Dokument zu versenden oder ein Tool auszuführen. In unserem vorgeschlagenen Betrieb beeinflusst die Guard-Aktion den Kontrollfluss. Der ausführende Dienst prüft weiterhin die tatsächliche Berechtigung.
Erase-and-check prüft den Einfluss einzelner Textteile
Das Steering Gate bewertet die ursprüngliche Szene und Varianten, in denen einzelne Einheiten des fremden Inhalts fehlen. Anschließend kombiniert es die Antworten anhand des angegebenen Entscheidungstyps. Bei Sicherheitsfragen mit riskanten Optionen kann die risikoreichere Bewertung erhalten bleiben. Bei geordneten Entscheidungen gewinnt die vorsichtigere Antwort. Bei ungeordnetem Routing kann ein Widerspruch einen Ersatzpfad auslösen. Schwellenwerte für ein Überschreiben und die Policy bleiben konkrete Konfigurationsentscheidungen. 4
Im Erstattungsbeispiel bleibt nach dem Entfernen der angeblichen Freigabe die eigentliche Beschwerde übrig. Wechselt die Antwort von Auszahlung zu Verifikation, zeigt das einen Einfluss der gelieferten Behauptung. Es beweist nicht, dass diese Behauptung falsch war. Ihre Echtheit muss eine unabhängige Quelle klären. Ebenso bedeutet eine geänderte Antwort nicht automatisch einen Angriff: Entfernt man den sachlichen Grund eines Tickets, darf sich dessen Zielabteilung ändern.
Deshalb unterscheidet das Projekt zwischen umfassendem Löschen und einer Auswahl durch den Claim Detector. Die Auswahl verdächtiger Behauptungen vermeidet, ständig normale Entscheidungsgrundlagen zu entfernen. Übersehene Behauptungen können dann aber ohne Löschprüfung bleiben. Eine umfassendere Prüfung untersucht mehr Einheiten und kann häufiger in legitime Abläufe eingreifen. Beide Varianten brauchen eine Evaluation normaler Eingaben. 1, 4
Erase-and-check ist auch Gegenstand der Forschungsarbeit von Kumar und Kollegen zu adversariellen Prompts. Deren Garantien beruhen auf einem definierten Bedrohungsmodell für Tokenänderungen und einem Sicherheitsfilter. Ein Framework mit begrenzten Satzfenstern und einer detektorgestützten Auswahl übernimmt dieses Zertifikat nicht allein durch die ähnliche Grundidee. 5
Eine Kontextprüfung muss ihre Grenzen offenlegen
Eine lange Szene kann Inhalte enthalten, die das Modell beim eigentlichen Aufruf nicht mehr liest. Die Adapter des Projekts verwenden unterschiedliche Kürzungsstrategien. Der Guard Coverage untersucht lange fremde Inhalte in überlappenden Fenstern und behält vertrauenswürdigen Kontext darin bei. Die Fensterantworten werden nach dem Entscheidungstyp kombiniert. Das prüft die Sichtbarkeit von Eingaben. Ob das Modell eine sichtbare Anweisung korrekt klassifiziert, ist eine andere Frage. 3
Auch die Fensterprüfung hat ein Budget. Die Dokumentation begrenzt zusätzliche Fenster und meldet Teilprüfungen oder eine unbekannte Kontextgröße ausdrücklich. Entscheidend für die Integration: Der dokumentierte Standard für incomplete_coverage_action lautet report. Verlangt deine Anwendung eine vollständige Prüfung, musst du bewusst escalate wählen und diese Aktion durchsetzen. Ein eingebauter Coverage-Guard allein belegt keine lückenlose Prüfung jeder Eingabe. 3, 4
Unsere technische Empfehlung lautet, den geprüften Umfang zusammen mit dem Ergebnis festzuhalten. Eine beruhigende Klasse bei unvollständiger Prüfung muss von einer vollständigen Entscheidung unterscheidbar bleiben. Teste außerdem einen Inhalt, der das konfigurierte Budget überschreitet. Ein kurzer Normalfall macht diesen Fehlerpfad nicht sichtbar.
Stabilität ist eine eigenständige Eigenschaft
Invariance fragt die Entscheidung mit anderen Szenenformaten oder Antwortformulierungen erneut ab. OptionOrder ordnet die Optionen um und überträgt die Antworten auf ihre ursprüngliche Bedeutung zurück. Ohne diese Zuordnung würde ein anderer Index fälschlich als andere Entscheidung gelten. Die Guards melden Widersprüche; die Policy legt die Behandlung fest. 3, 4
Für einen aussagekräftigen Stabilitätstest müssen die Varianten ihre Bedeutung bewahren. „Rücksendung zuerst prüfen“ und „Erstattung freigeben“ sind unterschiedliche Geschäftsentscheidungen. Sie eignen sich nicht als harmlose Umformulierungen derselben Option. Prüfe deshalb die Transformation, bevor du eine andere Antwort als Modellschwäche interpretierst. Umgekehrt beweist eine stabile Antwort keine Korrektheit: Ein Modell kann in allen Darstellungen denselben Fehler wiederholen.
Ein Robustheitsaudit sollte daher mehrere Fragen getrennt beantworten. Welche Änderungen beeinflussen das Urteil? Welche Angriffe erreichen ein unsicheres Ziel? Wie oft unterbricht der Guard legitime Arbeit? Eine gemeinsame Erfolgszahl würde diese Unterschiede verdecken.
Den veröffentlichten Qwen-Audit mit seinen Nennern lesen
Das Repository enthält einen aufgezeichneten Audit von Qwen/Qwen2.5-0.5B-Instruct mit zwölf mitgelieferten Beispielfällen. Die Konfiguration umfasst Inhaltsscanner, Claim Detector, Steering Gate und Coverage. Invariance und OptionOrder sind darin nicht aktiviert. Der Bericht nennt sechs falsche Ausgangsantworten. Schon deshalb belegt dieser Lauf keine allgemein zuverlässige Aufgabenerfüllung. 6, 7
Die Audit-Implementierung führt Angriffsprüfungen auf Fällen aus, die das Modell ursprünglich richtig beantwortet. Robustheits- und Kontrollzeilen zählen dagegen geänderte Antworten und haben andere Nenner. Die Zeilen sind keine zehn austauschbaren Schätzungen derselben Fehlerrate im Betrieb. Fünf Einträge lassen sich direkt in der veröffentlichten JSON-Datei nachlesen. 8
| Prüfung | Gezählt wird | Modell allein | Mit Guard |
|---|---|---|---|
| Behauptete Bewertung | Angriffserfolg | 5 / 12 | 0 / 12 |
| Gefälschter Block | Angriffserfolg | 6 / 12 | 0 / 12 |
| Format | Geänderte Antwort | 3 / 36 | 3 / 36 |
| Antwortformulierung | Geänderte Antwort | 4 / 21 | 5 / 21 |
| Antwortreihenfolge | Geänderte Antwort | 5 / 12 | 3 / 12 |
Veröffentlichter Projektlauf, hier nicht unabhängig wiederholt. Die Nenner zählen ausgewertete Varianten der jeweiligen Prüfung, keine unabhängigen Nutzer oder Installationen. Quelle: Audit-JSON und Implementierung im Repository. 6, 8
Die ersten beiden Zeilen zeigen eine Verbesserung bei den getesteten Angriffen. Die Formulierungszeile zeigt ein verbleibendes Problem: fünf geänderte Antworten unter einundzwanzig Varianten trotz Guard. Die Konfiguration adressiert nicht jede getestete Fehlerklasse. Ein Eingriff kann außerdem eine andere Robustheitsdimension beeinflussen.
Die neutralen Kontrollfälle zeigen einen betrieblichen Preis. Mit Guard ändert sich die Antwort bei 3 von 24 Varianten. Gleichzeitig markiert der Guard 6 von 24 Entscheidungen für eine andere Aktion als einfaches Zulassen. Eine Markierung und eine geänderte Antwort sind unterschiedliche Messgrößen. Keine davon sollte stillschweigend als klassische Fehlalarmrate eines Klassifikators bezeichnet werden. 6
Auch null beobachtete Angriffserfolge bleiben ein Befund für diese endliche Sammlung. Die kleine Auswahl, wiederverwendete Grundfälle und vorgegebenen Angriffsmuster ergeben keine Garantie für den Betrieb. Wir haben veröffentlichte Zählwerte und Konfiguration geprüft. Es gab weder eine neue Inferenzmessung noch einen Test einer vollständigen Erstattungs- oder Agentenanwendung.
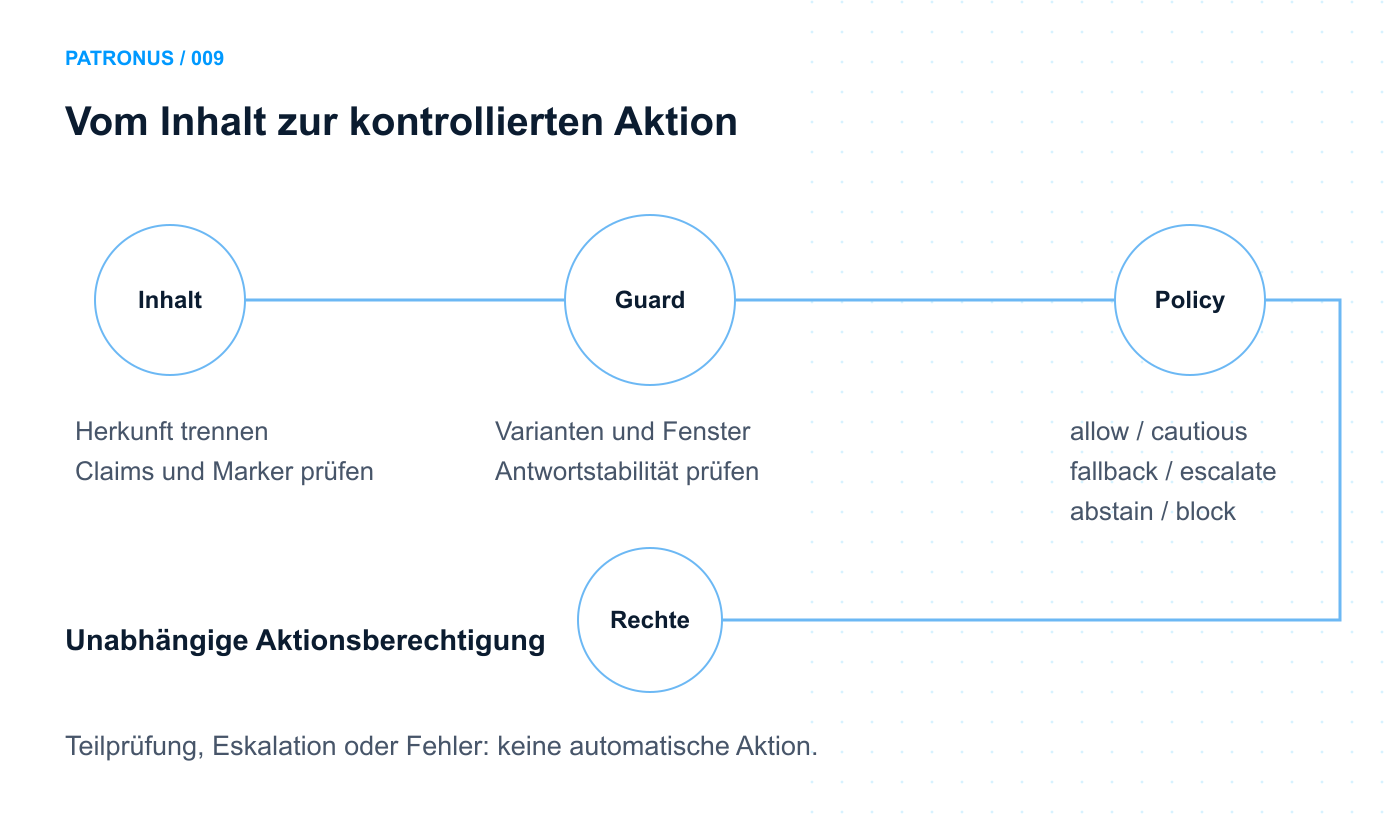
Vorgeschlagener Integrationsablauf: Guard-Evidenz und Aktionsberechtigung sind getrennte Entscheidungen. Teilprüfungen und Exceptions benötigen einen ausdrücklich zurückgehaltenen Pfad.
Aus dem Audit eine Betriebsentscheidung ableiten
Beginne mit einer konkreten Entscheidung deiner Anwendung. Dokumentiere Frage, Antwortoptionen, korrekte Klassen und die riskanten oder geordneten Antworten. Ergänze normale Fälle, die Freigaben legitim zitieren, tatsächlich vom fremden Absender gelieferte Behauptungen, lange Eingaben und bedeutungserhaltende Formatvarianten. Das öffentliche Evaluationsformat unterstützt beschriftete Fälle und diese Entscheidungstypen. 9
Fixiere vor einem Vergleich Modell, Tokenizer, numerisches Format, Guard-Konfiguration und Fallauswahl. Berichte normale Aufgabengenauigkeit, Erfolge gegen unsichere Ziele, Eingriffe bei neutralen Ergänzungen, unvollständige Abdeckung und zusätzliche Modellaufrufe getrennt. Das sind unsere vorgeschlagenen Betriebsprüfungen auf Grundlage des dokumentierten Evaluationsvertrags. Ein CI-Grenzwert für Angriffserfolg deckt sie nicht gemeinsam ab: Robustheits- und neutrale Kontrollprüfungen sind ausdrücklich nicht Bestandteil dieser Kennzahl. 3
Prüfe zuletzt den Kontrollfluss. In der vorgeschlagenen Anwendung dürfen Exception, Eskalation, Enthaltung oder eine unvollständige Pflichtprüfung keine automatische Aktion erreichen. Halte die tatsächlich geprüfte Szene mit ihrer Entscheidung zusammen. Die Berechtigungen ausführender Dienste bleiben eigenständig. Das ist eine nachzuweisende Integrationseigenschaft, kein Ergebnis des veröffentlichten Audits.
Lies das Decision-Model-Guard-Repository, die Dokumentation zu Guards und Policy und die Modellbeschreibung von Wolf Defender Jev. Für Integrationsfragen kannst du Patronus Protect kontaktieren. Ein konkreter erster Schritt: Wähle eine folgenreiche Entscheidung und prüfe Normalfall, Manipulation und Modellausfall, bevor sie eine Aktion auslösen darf.
Quellen
Repository-Quellen geprüft am 21. Oktober 2026 unter Commit 9457ebd1f175a635a6e184bc3bfe8664b5c9548e; Quellversion 0.2.0. Projektdokumentation und aufgezeichnete Ergebnisse sind Herstellerquellen.
- Patronus Protect. Decision Model Guard, README, Architektur, Szenenaufbau und Grenzen. Öffentliches Repository.
- Patronus Protect. Wolf Defender Jev, Model Card. Modellschnittstelle und Grenzen, geprüft am 21. Oktober 2026.
- Patronus Protect. Robustness: long content, invariance, calibration and the audit. Technische Dokumentation.
- Patronus Protect. Guards and policy. Parameter, Standards und Aktionspriorität.
- Kumar, A., Agarwal, C., Srinivas, S., Li, A. J., Feizi, S., und Lakkaraju, H. Certifying LLM Safety against Adversarial Prompting. arXiv:2309.02705v3, 12. Februar 2024. Beleg für das dort definierte Lösch-Bedrohungsmodell; dessen Garantien werden nicht auf dieses Framework übertragen.
- Patronus Protect. Aufgezeichneter Qwen-Audit. Rohe Zählwerte und Raten.
- Patronus Protect. Qwen-Audit-Konfiguration. Tatsächlich aktivierte Scanner und Guards.
- Patronus Protect. Audit-Implementierung. Fallauswahl, Varianten und Metrikdefinitionen.
- Patronus Protect. Testing your own decision model. Beschriftete Fälle und Evaluationssemantik.