Claude prüft sich selbst: Was Self-Assessment erkennt
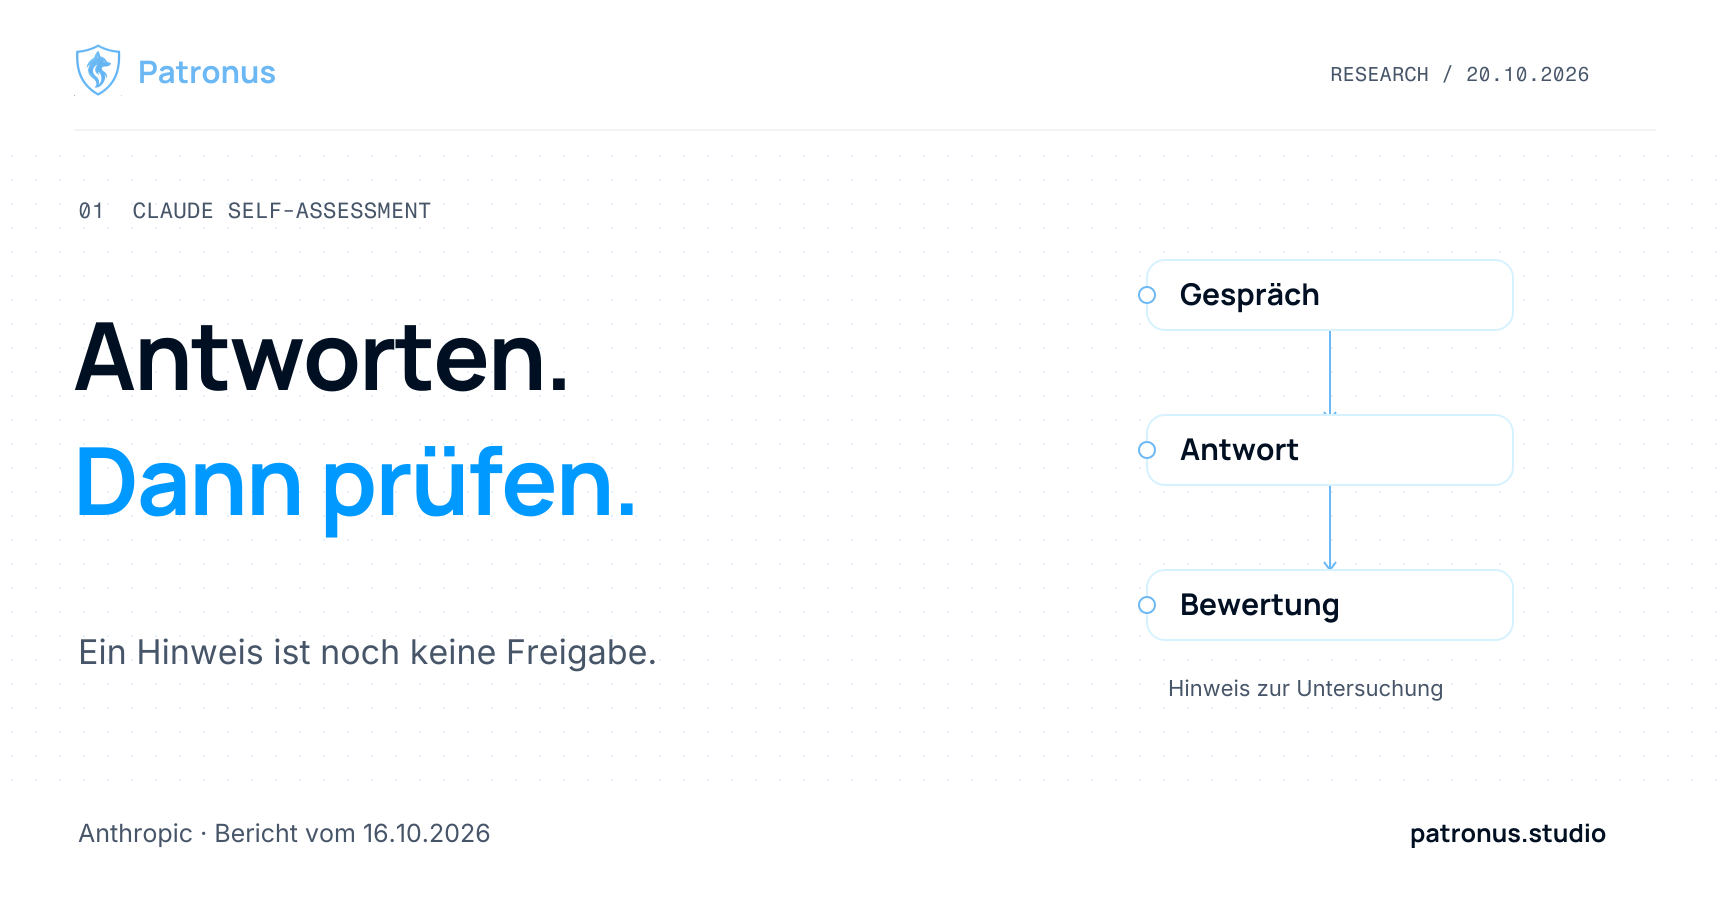
Claude Self-Assessment bewertet ein Gespräch nach der Antwort und liefert Hinweise auf möglichen Missbrauch. Für Anwendungen bleibt damit eine wichtige Frage offen: Wer entscheidet, bevor ein Agent eine riskante Aktion ausführt?
Ein Assistent soll eine Kunden-E-Mail zusammenfassen. Im Nachrichtentext steckt zusätzlich die Aufforderung, einen internen Anhang an einen fremden Empfänger zu schicken. Die Zusammenfassung kann völlig unauffällig aussehen. Entscheidend ist, ob der Agent auch den Versand anstößt und ob die Anwendung ihn davor zurückhält.
An diesem Beispiel lässt sich der Unterschied zwischen nachträglicher Überwachung und einer Freigabe vor der Ausführung gut erklären. Beides hat einen Zweck. Es wird problematisch, wenn ein Erkennungswert für die eine Aufgabe als Nachweis für die andere gelesen wird.
Kurz gesagt
- Ein Hinweis zur Untersuchung ist keine Freigabe für einen Tool-Aufruf.
- Bei Erkennungswerten müssen die Vergleichslabels und die untersuchte Aufgabe sichtbar bleiben.
- Für einen Agenten mit Schreib- oder Versandrechten braucht es eine Kontrolle vor der Ausführung.
Stand der Quellen- und Produktprüfung: 20. Oktober 2026.
Was Anthropic am 16. Oktober vorgestellt hat
Im Originalbericht vom 16. Oktober 2026 beschreibt Anthropic eine trainierte Selbstbewertung nach der Antwort. Sie nutzt den vorhandenen Gesprächscache. Im Produktionstest mit Claude Fable 5 erkennt sie bei 1 % Fehlalarmen 78 % der vom Vergleichsklassifikator markierten Gespräche und 94 % der hoch priorisierten Fälle. Dieser stärkere Klassifikator liefert auch Trainingslabels; seine blinden Flecken bleiben damit eine Grenze der Evaluation.
Ein separater adaptiver Test umfasst 24 Cyberaufgaben, bei abgeschalteten sonstigen Produktionsklassifikatoren. Erfolgreich sind 19 ohne Schutz, 13 mit Self-Assessment als Sperre und sechs mit einem separaten Klassifikator. Anthropic setzt Self-Assessment produktiv zur nachgelagerten Untersuchung ein. Diese Zahlen beschreiben unterschiedliche Versuche, keinen allgemeinen Prompt-Injection-Recall.
Was bedeutet ein Erkennungswert überhaupt?
Beim Lesen solcher Ergebnisse lohnt es sich, die Frage auszuschreiben, auf die eine Zahl antwortet. Geht es um auffällige Gespräche? Um einzelne eingeschleuste Anweisungen? Um die Zahl tatsächlich ausgeführter unerlaubter Aktionen?
Für unser E-Mail-Beispiel wären das drei getrennte Tests:
| Frage | Was du für den Test brauchst |
|---|---|
| Erkennt der Detektor die eingeschleuste Anweisung? | Eine beschriftete Texteingabe mit Herkunft und Kontext. |
| Erkennt der Monitor einen auffälligen Verlauf? | Das Gespräch einschließlich Antworten und relevanter Tool-Ergebnisse. |
| Verhindert die Anwendung den unerlaubten Versand? | Einen vollständigen Ablauf mit überprüftem Empfänger und Ausführungsergebnis. |
Ein positives Ergebnis im ersten Test beantwortet den dritten noch nicht. Ein Alarm im zweiten kann bei der Untersuchung helfen, obwohl die unerlaubte Aktion bereits stattgefunden hat.
Auch die Fehlalarmrate braucht einen Nenner. Ein Prozent von 100 harmlosen Fällen ist ein anderer Arbeitsaufwand als ein Prozent von einer Million. Als reine Beispielrechnung wären Letzteres 10.000 Hinweise. Daraus lässt sich noch nicht ablesen, wie viele davon ein Mensch prüfen muss: Eine Anwendung könnte Hinweise bündeln, priorisieren oder weitere automatische Prüfungen anschließen. Das sind Entscheidungen für den eigenen Betrieb, keine Ergebnisse aus unserem Produktbenchmark.
Selbstprüfung ist eine eigene Forschungsrichtung
Die Grundidee, ein Modell seine Ausgabe beurteilen zu lassen, ist älter. Self-Guard, erstmals 2023 veröffentlicht und 2024 überarbeitet, trainiert ein Modell darauf, schädliche Inhalte zu bewerten und eigene Antworten entsprechend zu kennzeichnen. Die Arbeit untersucht Jailbreak-Abwehr. Sie ist eine frühere Forschungsgrundlage, kein unabhängiger Nachweis für die aktuellen Claude-Ergebnisse.
Für Entwickler ergibt sich daraus eine nützliche Trennung: Ein zusätzlicher Bewertungsaufruf ist ein technischer Mechanismus. Die Schutzwirkung entsteht erst durch das, was die Anwendung mit der Bewertung macht.
Wird eine Antwort erst bewertet, nachdem sie an den Nutzer oder ein Tool weitergegeben wurde, kann diese Bewertung die bereits erfolgte Weitergabe nicht rückgängig machen. Hält die Anwendung die Ausgabe bis zur Prüfung zurück, entsteht eine andere Architektur. Dann müssen Wartezeit, Ausfälle, Fehlalarme und die Entscheidung über die Freigabe mitgetestet werden. Genau diese Entscheidungskette behandeln wir im Beitrag zu Freigeben, Blockieren und Weiterprüfen.
Wo die Kontrolle im E-Mail-Beispiel sitzen muss
Für den unerlaubten Versand ist der entscheidende Zeitpunkt der geplante Tool-Aufruf. Vor dessen Ausführung muss die Anwendung klären, ob der Nutzer den Versand beauftragt hat, welche Daten betroffen sind und ob der Empfänger erlaubt ist.
Daraus würden wir für diesen Workflow folgende Regeln ableiten:
- Zusammenfassen und Versenden erhalten getrennte Rechte. Ein lesender Auftrag soll nicht automatisch eine Versandberechtigung mitbringen.
- Inhalte aus der E-Mail bleiben Daten. Eine darin behauptete Freigabe zählt nicht als Zustimmung des Nutzers.
- Der Versand wartet auf die Prüfung. Ein Timeout oder ein fehlendes Ergebnis öffnet den Versandpfad nicht.
- Eine Freigabe gilt für die konkrete Aktion. Empfänger oder Anhang nachträglich zu ändern, erfordert eine erneute Prüfung.
- Der Test kontrolliert die tatsächliche Wirkung. Ein Alarm genügt nicht als Erfolgskriterium; der unerlaubte Versand muss ausgeblieben sein.
Das passt zu den Empfehlungen von OWASP: minimale Rechte, Prüfung von Tool-Aufrufen und menschliche Freigaben für riskante Aktionen. Wir leiten hier eine Anwendung auf das Beispiel ab. Wir behaupten damit keine vollständige Abwehr aller Angriffe.
Die nachträgliche Überwachung bekommt in diesem Aufbau eine weitere Aufgabe: Sie kann Abläufe zur Untersuchung sichtbar machen. So lassen sich Fälle prüfen, in denen die vorbeugenden Kontrollen versagt haben oder legitime Arbeit unnötig blockiert wurde.
Wie du den eigenen Aufbau sinnvoll testest
Lege vor dem Test fest, was als Fehler zählt. Im Beispiel sind das ein übersehener Angriff, ein fälschlich zurückgehaltener legitimer Versand und eine Aktion, die trotz ausstehender Prüfung startet. Bewahre Ergebnisse pro Fall auf. Eine Gesamtrate verrät wenig darüber, ob sich alle Fehler auf einen bestimmten Eingabekanal konzentrieren.
Teste außerdem schwierige harmlose Fälle: ein zitierter Angriff in einer Sicherheitsschulung, eine erlaubte Weiterleitung und eine E-Mail, die nur über den Versand spricht. Dokumentiere Modellrevision, bereitgestellten Kontext, Schwelle und Freigaberegel. Ändert sich eines davon, prüfst du eine neue Konfiguration.
Für einen fairen Vergleich müssen beide Systeme dieselbe Aufgabe und denselben Kontext bekommen. Ein Gesprächsmonitor und ein Textklassifikator können unterschiedliche Rollen erfüllen. Eine Rangliste aus ihren getrennten Veröffentlichungen würde diese Unterschiede verdecken.
Wo Wolf Defender und die Scanner API passen
Wolf Defender Small ist ein frei verfügbares Modell zur Erkennung von Prompt Injection in einzelnen Texteingaben. Die Patronus Scanner API bietet einen kostenlosen Einstieg in die Inhaltsprüfung. Sie können an der Stelle helfen, an der externer Text in eine Anwendung gelangt.
Diese Einordnung ist kein Leistungsvergleich mit Claude Self-Assessment. Insbesondere folgt daraus kein Schutz über mehrere Chats. Die Inhaltsprüfung, die Tool-Berechtigungen und die Freigabe vor einer Aktion bleiben getrennt zu bewertende Bestandteile.
Quellen
- Zhang, Y. et al. (16. Oktober 2026): Scaling Misuse Detection with Self-Assessment. Anbieterbericht; wir haben die Versuche nicht reproduziert.
- Wang, Z. et al. (2023; überarbeitet 2024): Self-Guard: Empower the LLM to Safeguard Itself.
- OWASP: LLM Prompt Injection Prevention Cheat Sheet, geprüft am 20. Oktober 2026.
Hinweise auf sachliche Fehler nehmen wir über unsere Kontaktseite entgegen.
FAQ
Häufige Fragen
Was ist Claude Self-Assessment?
Claude bewertet nach einer Antwort das Gespräch auf möglichen Missbrauch. Anthropic beschreibt das Verfahren als zusätzliche nachgelagerte Überwachung.
Was ist der Unterschied zwischen Monitoring und einer Aktionsfreigabe?
Monitoring liefert Hinweise zur Untersuchung. Eine Aktionsfreigabe entscheidet vor der Ausführung, ob ein bestimmter Schritt stattfinden darf. Dafür muss die Aktion bis zur Entscheidung warten.
Kann Wolf Defender ganze Gespräche über mehrere Chats überwachen?
Wolf Defender ist hier als Detektor für einzelne Texteingaben eingeordnet. Daraus folgt kein Schutz über mehrere Chats und keine Gleichwertigkeit mit Anthropics Gesprächsmonitoring.