Wie NTDBs ohne Transformer entscheiden
Teil II unserer Serie über den Aufbau von Patronus Ark für CPU-basierte KI-Security-Inferenz.
In Teil I haben wir Layer 2 vereinfacht beschrieben: NTDBs treffen die günstige Entscheidung, Lion Warden läuft nur, wenn mehr Tiefe benötigt wird.
Interessant ist, wie diese günstige Entscheidung entsteht. Layer 2 kann nicht einfach eine kleinere Kopie von Layer 3 sein. Ein weiterer Transformer würde genau die Speicher- und Latenzprobleme zurückbringen, die wir beseitigen wollten. Layer 2 auf den Konfidenzwert eines kleinen Klassifikators zu reduzieren, würde uns jedoch nicht genug Informationen geben, um zu entscheiden, ob Layer 3 tatsächlich nötig ist.
NTDBs sind unsere Antwort auf dieses Problem.
Der Name steht für Non-Transformer Decision Block. Die Klassifikatoren innerhalb eines NTDB verwenden keine Transformer-Schichten. Der Block kann trotzdem Attention über mehrere Chunks einsetzen; Attention allein macht eine Architektur noch nicht zu einem Transformer.
In der aktuellen Ark-Pipeline wird die Eingabe über den gemeinsamen mmBERT-Stack tokenisiert und eingebettet. Layer 2 bildet aus den statischen Token-Embeddings einen gemittelten 384-dimensionalen Vektor pro Chunk. Die Repräsentation auf Token-Ebene bleibt für Chunks erhalten, die später durch die kontextuellen Schichten von Lion Warden laufen. Aus dem gemittelten Vektor kombiniert ein NTDB kleine neuronale Komponenten mit Klassifikatoren wie LightGBM und logistischer Regression. So entstehen ein L2-Ergebnis und eine deutlich größere Feature-Repräsentation für das Promote Gate, ohne die 22 kontextuellen Schichten von Lion Warden auszuführen.
Warum die Entscheidung bei Chunks beginnt
Ark verarbeitet Eingaben in Fenstern mit bis zu 256 Token, weil Security-Signale oft lokal auftreten. Eine Datei mit 30.000 Token kann eine einzige kurze injizierte Anweisung enthalten. Der umgebende harmlose Inhalt darf dieses Signal nicht herausmitteln.
Der zweite Grund ist die Ausführung.
Sobald ein Chunk eingebettet wurde, ist er ein Vektor. Ein Dokument mit N Chunks ist damit keine Folge aus N getrennten Textklassifikationsanfragen mehr. Es ist eine Matrix aus Chunk-Vektoren, die gemeinsam durch Layer 2 laufen kann.
Auf einer CPU ist das entscheidend. Einen großen Teil des Ausführungsaufwands zahlen wir nur einmal und verwenden optimierte Matrixoperationen, statt jeden Klassifikator für jeden Chunk einzeln aufzurufen. In unseren Messungen skaliert die daraus entstehende Wall-Clock-Zeit deutlich besser als eine serielle Verarbeitung Chunk für Chunk. Wir behaupten keine andere asymptotische Komplexität; der Gewinn entsteht durch die effiziente Verarbeitung der Chunk-Matrix.
Chunking gibt uns damit beide Eigenschaften, die wir brauchen: Lokale Security-Evidenz bleibt sichtbar, während lange Eingaben effizient genug für die Verarbeitung auf einer CPU bleiben.
Warum Layer 2 die mmBERT-Repräsentation nutzt
LightGBM und logistische Regression benötigen keine Embeddings. Ein LightGBM-Klassifikator könnte auch auf einer dünn besetzten N-Gram- oder TF-IDF-Matrix trainiert werden. Das wäre weiterhin ein gültiger Layer-2-Klassifikator.
Es wäre aber nicht die Architektur, die wir für Ark brauchen.
Unsere NTDBs verwenden denselben Tokenizer, dieselbe Embedding-Schicht, dieselben Dimensionen und denselben latenten Raum wie Lion Warden. Wir tokenisieren und betten einmal ein. Layer 2 verarbeitet eine gemittelte 384-dimensionale Sicht auf jeden Chunk, während weitergeleitete Chunks die Token-Embeddings behalten, die von den tieferen mmBERT-Schichten benötigt werden. Es muss kein zweiter Tokenizer, kein zweites Vokabular und kein zweites Embedding-Modell geladen werden.
Die Einsparungen bei Speicher und Latenz sind erheblich. Der gemeinsame latente Raum ist jedoch nicht nur eine Optimierung, sondern Teil des Promotion-Problems selbst.
Das Promote Gate soll lernen, ob zusätzliche Tiefe eine Entscheidung verändert. Es soll nicht feststellen, ob zwei unabhängige Feature-Systeme zufällig unterschiedlicher Meinung sind. Layer 2, Layer 3 und das Gate müssen deshalb mit kompatiblen Repräsentationen derselben Eingabe arbeiten. Andernfalls würde sich ein Representation Shift mit der Routing-Entscheidung vermischen.
Hier verbindet sich die Architektur auch mit statistischer Lerntheorie. Wir begrenzen den Hypothesen- und Entscheidungsraum, statt das Promote Gate beliebige Modelle mit beliebigen Repräsentationen vergleichen zu lassen. Die zugrunde liegenden Koordinaten bleiben gleich; nur die Menge der darauf angewendeten kontextuellen Berechnung verändert sich. Dadurch wird die gelernte Grenze zwischen „L2 reicht aus“ und „L3 liefert zusätzliche Information“ deutlich klarer definiert.
Was ein NTDB-Head tatsächlich berechnet
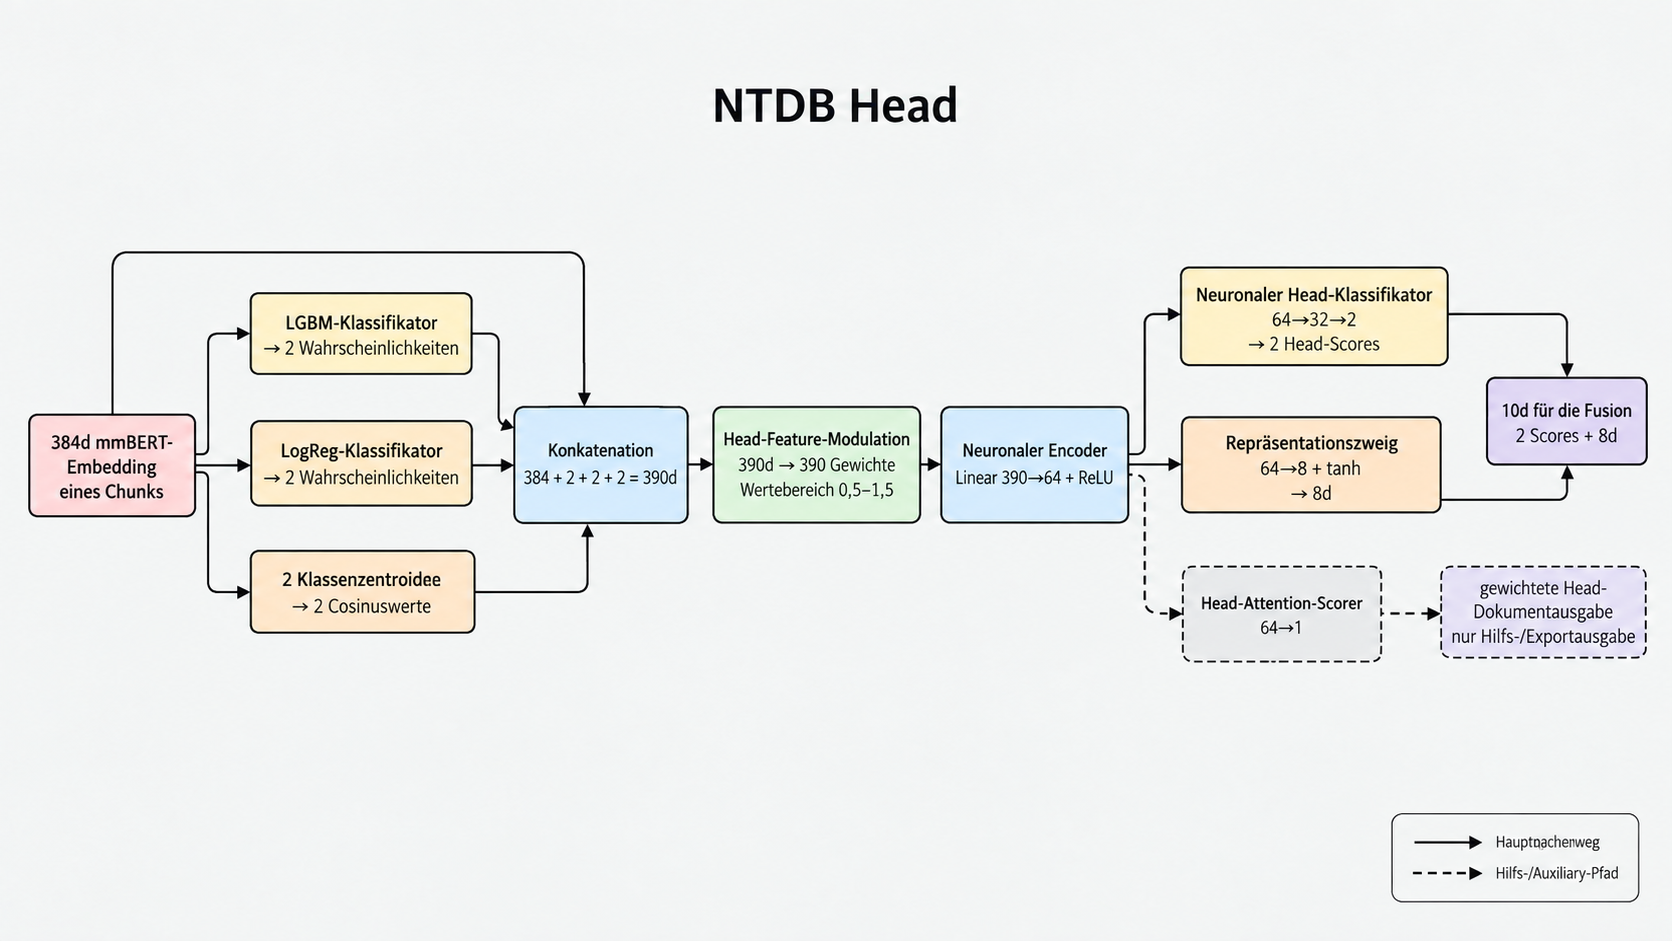
Das 384-dimensionale statische mmBERT-Embedding ist nur der Ausgangspunkt. In der aktuellen Injection-Architektur verarbeitet ein NTDB-Head dieses Embedding mit einem LightGBM-Klassifikator, logistischer Regression und zwei Klassen-Zentroiden. Die beiden Klassifikatoren liefern jeweils zwei Wahrscheinlichkeiten; die Zentroide liefern zwei Kosinusähnlichkeiten. Zusammen mit dem ursprünglichen Embedding ergibt das eine 390-dimensionale Eingabe für den neuronalen Teil des Heads.
Der nächste Schritt ist die Feature-Modulation. Statt alle 390 Dimensionen für jeden Chunk als gleich wichtig zu behandeln, lernt der Head ein kontextabhängiges Gewicht für jedes Feature. Der modulierte Vektor wird auf 64 Dimensionen projiziert. Daraus erzeugt der Head zwei Klassenscores und eine kompakte acht-dimensionale Repräsentation. Die Ausgabe eines Heads besitzt damit zehn Dimensionen und ist nicht bloß ein finaler Konfidenzwert.
Ein NTDB-Head. Die durchgezogene Linie zeigt den Laufzeitpfad pro Chunk. Der gestrichelte Attention-Zweig erzeugt eine gewichtete Ausgabe auf Head-Ebene für Hilfs- oder Exportzwecke; er ist nicht die finale Dokumentaggregation von Ark.
Ark führt aktuell drei solcher Heads pro Injection-Chunk aus: den Patronus-Head, den Jayavibhav-Head und einen L3-Surrogate-Head. Ihre drei zehn-dimensionalen Ausgaben werden zu 30 Dimensionen verkettet, erneut moduliert und durch einen kleinen Fusion-Encoder geführt. Daraus entstehen die fusionierte L2-Repräsentation und die finale L2-Wahrscheinlichkeit für diesen Chunk.
In Multiclass-Pipelines können zusätzliche NTDB-Heads One-vs-Rest-Entscheidungen umsetzen. Das ist eine Zerlegung der Klassifikationsaufgabe. Mehr Heads sind kein automatischer Mechanismus zur Reduzierung von False Positives. Verschiedene Pipelines können unterschiedliche Head-Strukturen verwenden und trotzdem denselben grundlegenden Block-Contract beibehalten.
Die exportierte Architektur enthält Attention, ihre Rolle muss jedoch klar vom Hauptpfad der Runtime getrennt bleiben. Ein Head kann Repräsentationen über mehrere Chunks bewerten und gewichten, um eine globale Hilfsausgabe zu bilden. Wenn die Runtime einen einzelnen Chunk bewertet, gibt es nichts Sinnvolles, worüber Attention berechnet werden könnte: Die 64-dimensionale Repräsentation wird unverändert weitergegeben, und ein Softmax über ein einzelnes Element ist trivialerweise eins. Die selektive L2/L3-Entscheidung bleibt auf Chunk-Ebene. Die finale Dokumententscheidung ist weiterhin eine einfache Aggregation nach der Promotion.
Die NTDB-Ausgabe ist kein Dokumenturteil
Layer 2 entscheidet nicht zuerst, ob das vollständige Dokument sicher ist, um danach das Dokument zu Layer 3 weiterzuleiten. Es erzeugt einen Entscheidungszustand für jeden einzelnen Chunk. In der aktuellen Injection-Pipeline erhält der separate LightGBM-Promoter 1.886 Features pro Chunk.
Das Promote Gate arbeitet mit dieser Repräsentation und entscheidet, welche Chunks Lion Warden benötigen. Ein nicht weitergeleiteter Chunk behält sein L2-Ergebnis. Ein weitergeleiteter Chunk läuft durch Layer 3 und erhält das Ergebnis von Lion Warden.
Erst nach diesem Routing werden die Ergebnisse der Chunks zusammengeführt:
gemeinsame Chunk-Matrix
  → drei NTDB-Heads pro Chunk
  → 30d Head-Fusion → 64d fusionierte Repräsentation
  → L2-Ergebnis und 1.886 Promoter-Features pro Chunk
  → Promote Gate
      ├─ L2-Ergebnis behalten
      └─ L3 ausführen und Lion-Warden-Ergebnis verwenden
  → ausgewählte Chunk-Ergebnisse aggregieren
Für die Evaluation unterscheiden wir zwischen L2-only, L3-only und Union. Union ist der tatsächliche selektive Pfad: Nicht weitergeleitete Chunks behalten ihre L2-Ergebnisse, weitergeleitete Chunks tragen ihre L3-Ergebnisse bei.
Die finale Dokumentaggregation ist bewusst einfach. Abhängig von Pipeline und Operating Point verwendet Ark Funktionen wie max, mean oder smoothmax, gefolgt von einem gelernten Schwellwert. Am Ende der Pipeline versteckt sich kein zweiter Attention-Mechanismus.
Was Layer 2 verändert
NTDBs ersetzen Lion Warden nicht. Sie verhindern, dass Ark jeden Chunk so behandelt, als würde er das vollständige Modell benötigen.
Ihre nützliche Ausgabe ist mehr als eine günstige Vorhersage. Für jeden Chunk stellt Layer 2 genug vom eigenen Entscheidungszustand bereit, damit ein separates Modell abschätzen kann, ob zusätzliche kontextuelle Berechnung sinnvoll ist. Ein Konfidenzschwellwert kann das nicht zuverlässig beantworten. L3 kann L2 korrigieren, bestätigen oder ein richtiges Ergebnis durch ein schlechteres ersetzen.
Teil III untersucht diesen überlappenden Entscheidungsraum und das darauf trainierte Promote Gate. Dort gehören auch die aktuellen Ergebnisse zu Latenz, Promotion-Rate und Qualität hin.