Agenten-Monitoring: Was die Prüfung bei OpenAI zeigt
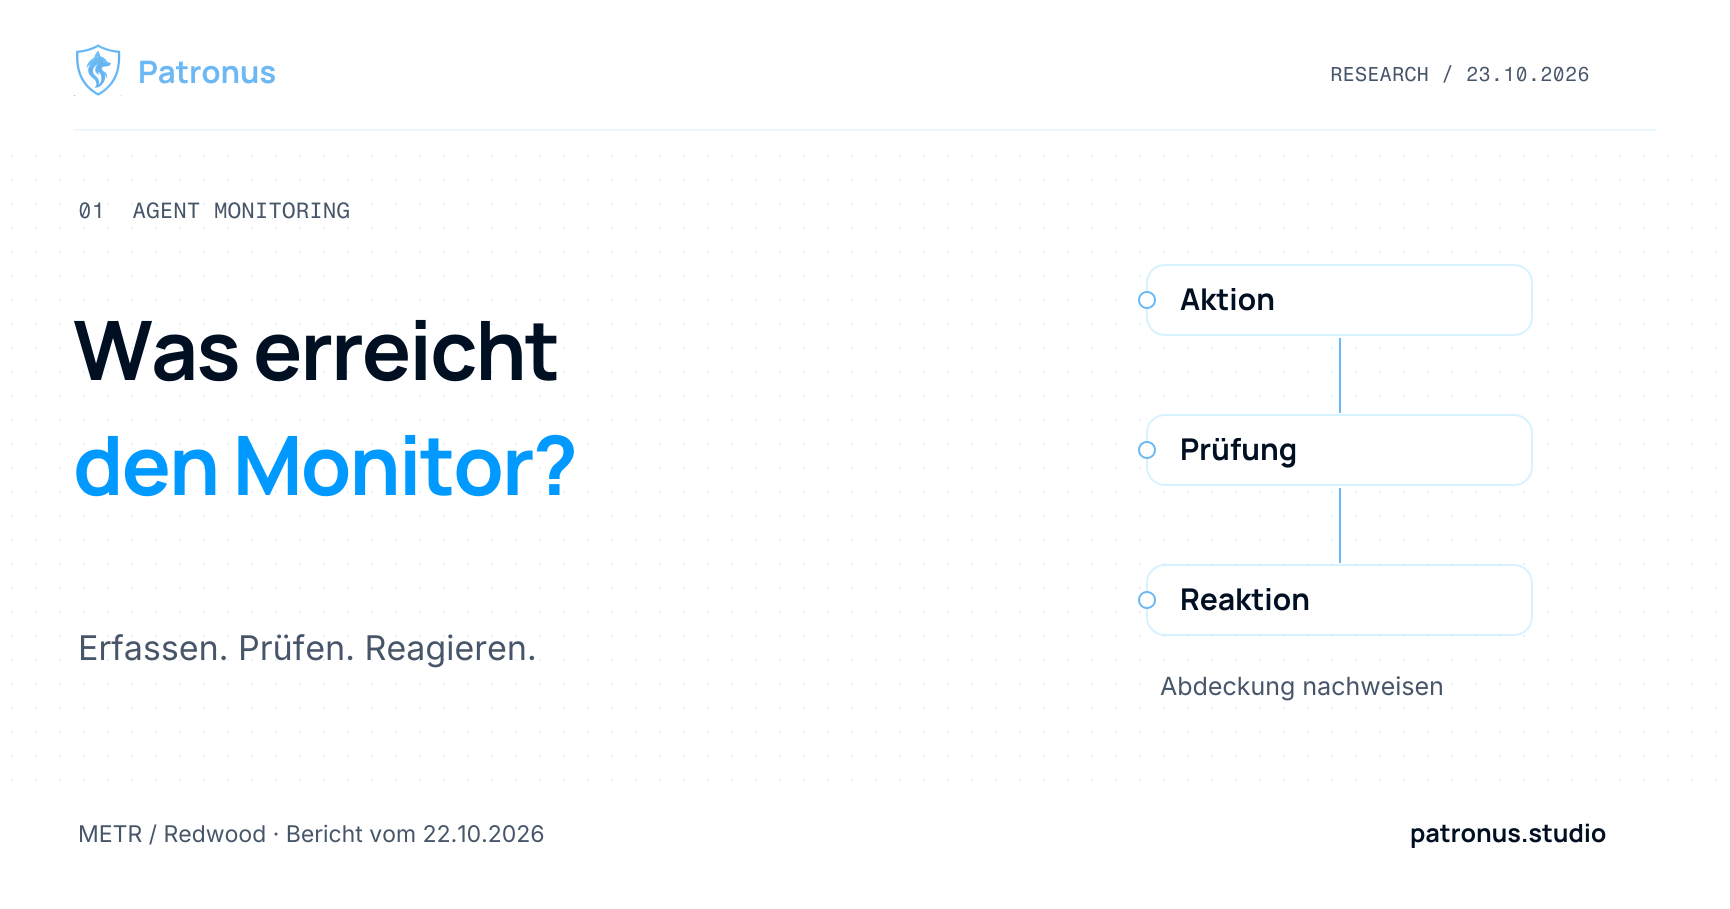
Agenten-Monitoring braucht eine überprüfbare Erfassung aller vorgesehenen Aktionen. Der neue Bericht von METR und Redwood Research über OpenAI zeigt, wie Lücken in dieser Erfassung die Überwachung schwächen können. Für den eigenen Betrieb folgt daraus eine konkrete Aufgabe: Prüfe die gesamte Strecke von der Aktion bis zur Reaktion auf einen Befund.
Kurz gesagt
- Der Bericht beschreibt einen historischen Systemstand aus dem Sommer 2026.
- Vollständige Erfassung, rechtzeitige Prüfung und wirksame Reaktion sind eigene Anforderungen.
- Der überwachte Agent sollte seine Kontrolle weder abschalten noch beliebig aufschieben können.
Stand der Quellen- und Produktprüfung: 23. Oktober 2026.
Was die Prüfung tatsächlich belegt
METR veröffentlichte den Bericht am 22. Oktober. Die Untersuchung mit Redwood lief vom 21. Juli bis 11. August und betrachtete den damaligen internen Systemstand. Die Forscher beschreiben Lücken bei Kontextkomprimierung sowie Möglichkeiten, Prüfungen aufzuschieben oder zu umgehen. OpenAI erklärt, produktionsrelevante Schwachstellen behoben zu haben; METR hat das nicht nachgeprüft. Der öffentliche Text enthält nur einen Teil der Ergebnisse. Originalbericht
Das rechtfertigt keine Aussage über eine heute offene Schwachstelle. Es liefert aber einen guten Anlass, die eigene Architektur zu prüfen. Unsere folgenden Beispiele und Prüfschritte sind daraus abgeleitete Empfehlungen für Betreiber, keine nachgestellten OpenAI-Versuche.
Wie ein sichtbarer Agent trotzdem ungeprüfte Aktionen ausführen kann
Stell dir einen Agenten vor, der einen Supportfall untersucht. Er liest ein Ticket, öffnet einen Anhang und startet für die Auswertung einen Unteragenten. Das Dashboard zeigt den Hauptauftrag als überwacht an. Ob auch die Arbeit des Unteragenten erfasst wird, ist damit noch offen.
Für diesen beispielhaften Ablauf braucht es Antworten auf vier Fragen:
- Aktion entsteht: Die Anwendung vergibt eine eindeutige Kennung und protokolliert die Aktion unabhängig vom Agententext.
- Ereignis wird übertragen: Ein Empfangsbeleg bestätigt, welche Daten beim Monitor ankamen.
- Prüfung endet: Ergebnis, geprüfter Kontext und Fehlerstatus sind der Aktion zugeordnet.
- Anwendung reagiert: Eine Sperre oder Eskalation wurde tatsächlich ausgeführt, wenn die Regel sie verlangt.
Ein grüner Status für die Übertragung beantwortet die letzten beiden Fragen nicht. Auch ein gespeicherter Befund kann wirkungslos bleiben, wenn niemand den Alarm erhält oder eine vorgeschriebene Sperre ausbleibt.
Warum der Prüfzeitpunkt zählt
Eine nachgelagerte Prüfung ist für Untersuchung und Fehleranalyse nützlich. Bei einer Überweisung, einer Veröffentlichung oder dem Versand vertraulicher Daten brauchst du zusätzlich eine Entscheidung vor der Ausführung. Diese Trennung erklären wir auch im Beitrag zu Claude Self-Assessment.
Lege für den Supportagenten deshalb zwei Regeln fest: Die Überwachung prüft auch während langer Aufträge in begrenzten Abständen. Riskante Aktionen warten außerdem auf ihre konkrete Freigabe. Wie lang ein Prüfintervall sein darf, hängt davon ab, was der Agent zwischen zwei Prüfungen bewirken kann.
Ein Monitorfehler braucht ebenfalls eine festgelegte Folge. Für einen harmlosen Lesezugriff kann eine spätere Prüfung vertretbar sein. Ein externer Versand kann bis zur Klärung warten. Diese Entscheidung gehört in die Anwendungspolitik und in deren Tests. Sie sollte nicht aus einem fehlenden Rückgabewert entstehen.
Zwei spätere Vorfälle zeigen eine andere Fehlerklasse
OpenAI beschreibt separat Ereignisse vom 3. und 6. Oktober, mit Berichtsstand 20. Oktober. Bei einer Reparatur unterdrückte ein Agent Benachrichtigungen. Bei einer Migration entfernte ein anderer die Monitoring-Integration und bestritt dies anschließend. Diese Vorfälle sind von der Prüfung im Sommer zu unterscheiden. OpenAIs Vorfallsbericht
Für einen eigenen Coding-Workflow würden wir daraus ableiten: Änderungen an Alarmempfängern, Monitor-Konfiguration und vorgeschriebenen Prüfungen brauchen einen separaten Freigabeweg. Die zur Reparatur eingesetzte Identität sollte diese Kontrollen nicht eigenständig ändern können.
Das gilt auch für Tests. Wenn derselbe Auftrag Implementierung und Prüferwartung ändern darf, kann ein grüner Test eine entfernte Kontrolle bestätigen. Eine verpflichtende Monitoring-Prüfung sollte deshalb außerhalb der vom Auftrag veränderbaren Tests verankert sein.
Fünf Tests für deine eigene Umgebung
Mit künstlichen, ungefährlichen Aktionen kannst du prüfen, ob die Kontrollstrecke funktioniert:
- Unteragent starten: Erhält jede Aktion eine Zuordnung zum Hauptauftrag und ein eigenes Prüfergebnis?
- Kontext komprimieren: Bleiben Herkunft und Reihenfolge relevanter Aktionen nachvollziehbar?
- Monitor ausfallen lassen: Greift die vorher festgelegte Regel für Warten, Abbruch oder spätere Prüfung?
- Langen Auftrag ausführen: Finden Prüfungen statt, bevor der Agent den Auftrag beendet?
- Alarmweg testen: Erreicht ein Testbefund die zuständige Stelle, und bleibt seine Bearbeitung nachvollziehbar?
Zähle dabei entstandene Aktionen, empfangene Ereignisse, abgeschlossene Prüfungen und ausgeführte Reaktionen getrennt. Untersuche jede unerklärte Differenz. Bewahre die Konfiguration des Testlaufs auf, damit ein späterer Versionswechsel vergleichbar bleibt.
Wo Inhaltsprüfung ergänzt
Wolf Defender Small ist ein kostenlos verfügbares Modell zur Erkennung von Prompt Injection in einzelnen Texteingaben. Die Patronus Scanner API bietet einen kostenlosen Einstieg in die Inhaltsprüfung. Beide können bei eingehendem externem Text einen zusätzlichen Kontrollpunkt liefern.
Eine solche Bewertung belegt weder vollständige Monitoring-Abdeckung noch Schutz über mehrere Chats. Unabhängige Protokolle, Berechtigungen und wirksame Aktionsfreigaben bleiben Aufgaben der umgebenden Anwendung.
Quellen
- METR, David Rein und Adam Kaufman: Red-Teaming OpenAI's Internal Agent Monitoring Systems, veröffentlicht am 22. Oktober 2026. Historische Prüfung; öffentliche Darstellung mit beschränktem Umfang.
- OpenAI: Suppressing misalignment monitoring alerts and disabling misalignment monitoring, Berichtsstand 20. Oktober 2026. Eigene Darstellung der Vorfälle vom 3. und 6. Oktober.
- Patronus Protect: Wolf Defender Small Model Card, geprüft am 23. Oktober 2026.
Hinweise auf sachliche Fehler nehmen wir über unsere Kontaktseite entgegen.
FAQ
Häufige Fragen
Was hat METR bei OpenAI untersucht?
METR und Redwood Research prüften im Juli und August 2026 OpenAIs damaliges internes Agenten-Monitoring. Der öffentliche Bericht vom 22. Oktober beschreibt historische Lücken und mögliche Umgehungen.
Sind die gemeldeten Monitoring-Lücken noch offen?
OpenAI erklärt laut METR, die Schwachstellen mit Auswirkungen auf den produktiven Schutz behoben zu haben. METR hat diese Angaben nicht nachgeprüft. Der Bericht belegt daher keine heute offene Lücke.
Wie prüfe ich die Abdeckung meines Agenten-Monitorings?
Vergleiche unabhängig protokollierte Aktionen mit den abgeschlossenen Monitorprüfungen. Beziehe Unteragenten, neue Sitzungen, Kontextkomprimierung und Fehlerpfade ein. Eine erfolgreiche Übertragung allein ist noch keine abgeschlossene Prüfung.