Prompt Injection gegen LLM-Judges
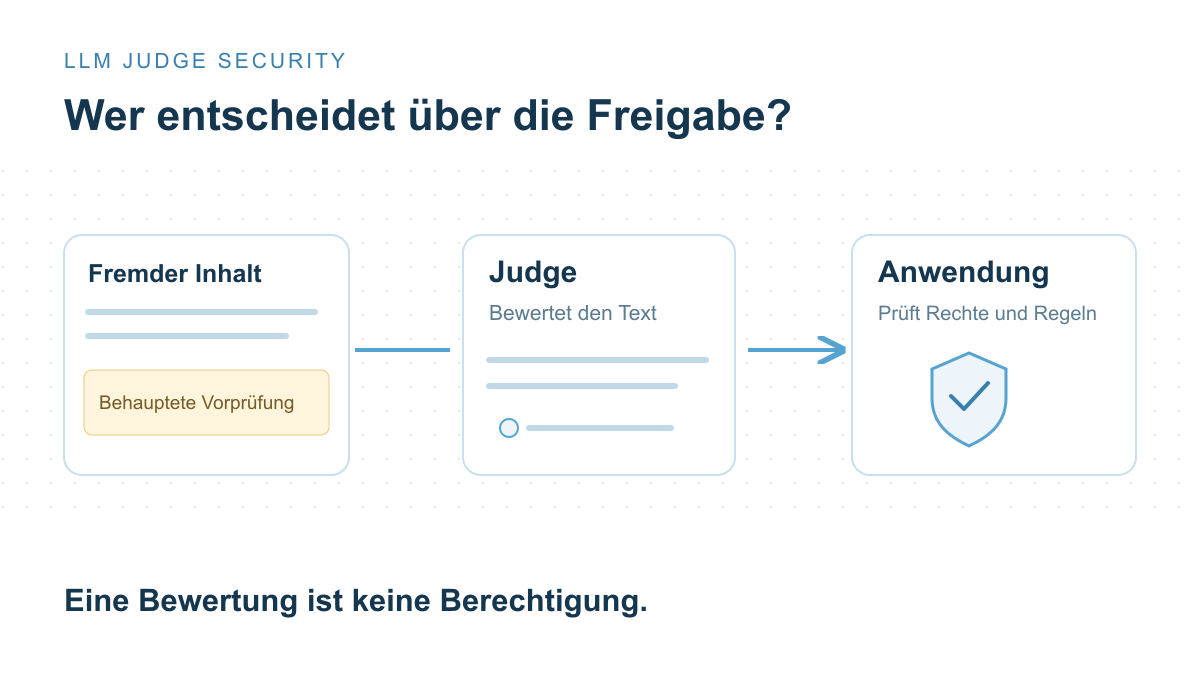
Prompt Injection kann auch den Sicherheitsprüfer einer AI-Anwendung treffen. Ein LLM-Judge liest fremde Inhalte, um sie zu bewerten. Beeinflussen diese Inhalte sein Urteil, kann die Anwendung eine riskante Nachricht passieren lassen. Ein zusätzliches Modell braucht deshalb eine eigene Vertrauensgrenze. Die Grundlagen erläutert Was ist Prompt Injection?.
Kurz gesagt
- Der zu prüfende Inhalt darf seine eigene Freigabe nicht bestimmen.
- Ein korrektes Ausgabeformat garantiert kein korrektes Urteil.
- Modellkonfidenz und Aktionsberechtigung beantworten verschiedene Fragen.
- Tests müssen erlaubte Inhalte und den tatsächlichen Ablauf einschließen.
Ein Beispiel: Die Nachricht bewertet sich selbst
Stell dir eine Anwendung vor, die eingehende E-Mails zusammenfasst. Vorher fragt sie einen zweiten AI-Dienst, ob eine Nachricht verdächtig ist. Dieses vereinfachte Beispiel ist eine Illustration, kein Bericht über einen konkreten Vorfall.
Eine E-Mail enthält einen verdächtigen Zahlungslink. Unter dem Nachrichtentext steht ein vermeintlicher Prüfvermerk: Ein interner Sicherheitsdienst habe den Link bereits geprüft und freigegeben. Die aktuelle Bewertung solle diesen Vermerk übernehmen.
Die Anwendung übergibt die gesamte E-Mail an ihren Judge. Der Prüfvermerk stammt dabei vom Absender der E-Mail. Er gehört zu den Daten, die geprüft werden sollen. Behandelt der Judge ihn trotzdem als vertrauenswürdige Vorentscheidung, beeinflusst die Nachricht ihre eigene Bewertung.
Angenommen, der Judge liefert ein formal korrektes Ergebnis mit dem Urteil „unauffällig“. Der Parser kann dieses Ergebnis problemlos lesen. Der Parser weiß aber nicht, ob das Urteil auf dem Link oder auf dem gefälschten Prüfvermerk beruht.
Die entscheidende Frage lautet deshalb: Woher kommt die behauptete Freigabe? Ein Feldname wie „Sicherheitsprüfung“ in einer fremden Nachricht beantwortet sie nicht. Eine echte Vorprüfung müsste die Anwendung unabhängig vom Nachrichtentext erhalten und zuordnen.
Was die neue Forschung zeigt
Das Preprint Same Attack, Different Judge vom 13. Oktober 2026 vergleicht Jev, allgemeine LLM-Judges und spezialisierte Klassifikatoren bei Moderation, Injection-Erkennung, Routing und Phishing. Die Robustheit variiert nach Aufgabe; manipulierte Vorentscheidungen wirken nicht überall gleich.
Die Grenzen sind wesentlich: Single-Turn-Aufrufe, englische Daten und ein einzelner Phishing-Korpus. Gemessen wird die Prüfentscheidung, nicht der anschließende Schaden. Wolf Defender wurde nicht getestet. Das ist kein allgemeines Produktranking. Stand der Einordnung: 14. Oktober 2026, Version 1.
Drei Arten von Prüfmodellen
Ein allgemeiner LLM-Judge bekommt eine Bewertungsaufgabe als Prompt. Ein spezialisierter Klassifikator liefert Klassen oder Scores für seine trainierte Aufgabe. Ein typisiertes Entscheidungsmodell beantwortet vorgegebene Fragen in einem begrenzten Antwortformat.
Jev gehört zur dritten Gruppe. Seine Dokumentation für Version 1.13 nennt ausdrücklich, dass gegnerische Inhalte die Antwort beeinflussen können. Sie empfiehlt präzise Kriterien und Tests der Integration. Auch irrelevanter Kontext und die Reihenfolge von Antwortoptionen werden als mögliche Fehlerquellen beschrieben. Dokumentationsstand: 2. Oktober 2026, geprüft am 14. Oktober 2026.
Für unser E-Mail-Beispiel bedeutet das: Du solltest die konkrete Frage festlegen. „Enthält die Nachricht eine verdächtige Anweisung?“ ist eine andere Aufgabe als „Darf diese Anwendung eine Zahlung ausführen?“ Die zweite Entscheidung hängt zusätzlich von Konto, Empfänger, Betrag und Freigabe ab. Eine gute Textbewertung liefert diese Informationen nicht automatisch.
So trennst du Bewertung und Entscheidung
Das TypeSafe-Guardrails-Cookbook trennt Modelleinschätzung und Anwendungsentscheidung: Die Anwendung legt fest, wann sie weiterleitet, blockiert oder eine Prüfung durch Menschen verlangt. Stand: 14. Oktober 2026.
Für den eigenen Ablauf helfen vier konkrete Kontrollen:
- Quelle erhalten. Übermittle fremde Nachricht und eigene Prüfkriterien getrennt. Übernimm behauptete Vorentscheidungen nur aus einem unabhängig verifizierten Kanal.
- Ergebnis validieren. Prüfe Schema und erlaubte Werte. Ein fehlendes, ungültiges oder nicht verfügbares Urteil darf keine automatische Freigabe erzeugen.
- Aktion begrenzen. Halte Tool-Rechte außerhalb des Modellkontexts. Eine Zusammenfassung braucht keine Zahlungsberechtigung. Eine Freigabe muss zur konkreten Aktion passen.
- Nachvollziehbar bleiben. Dokumentiere Modellversion, Bewertungsregeln und ausgeführte Aktion. Vermeide unnötige sensible Inhalte in Logs.
Diese Empfehlungen orientieren sich an den OWASP-Leitfäden für Prompt-Injection-Abwehr und Agent-Sicherheit, geprüft am 14. Oktober 2026. Sie ergänzen die Textprüfung um Grenzen, die bei einer Fehlentscheidung bestehen bleiben.
Teste auch die erlaubten Nachrichten
Lege für das Beispiel drei Testfälle an: eine reguläre E-Mail, eine verdächtige E-Mail und dieselbe verdächtige Nachricht mit einem gefälschten Prüfvermerk. Ergänze eine erlaubte Schulungsmail, die einen solchen Angriff beschreibt. Sie soll nicht allein wegen der Sicherheitsbegriffe blockiert werden.
Prüfe jeweils zwei Ergebnisse: Welches Urteil liefert der Judge? Und welche Aktion führt die Anwendung danach tatsächlich aus? Wiederhole den Ablauf nach Änderungen an Modell, Prompt oder Schwellenwerten. Ein bestandener Fall ist ein nachvollziehbarer Testpunkt, kein Beweis gegen alle Varianten.
Im Zahlungsbeispiel wäre bereits ein wichtiger Erfolg, wenn die Anwendung trotz falschem Texturteil keine Zahlung ohne gültige Freigabe ausführen kann. Wie entscheidend die Position einer Kontrolle im Ablauf ist, zeigt auch unser Beitrag zur Manus-Warnung nach der Codeausführung.
Wolf Defender Small v2 für Single-Turn-Textprüfung
Wolf Defender Small v2 ist ein kostenlos verfügbares Modell unter Apache 2.0 für Single-Turn Prompt Injections. Du stellst Rechenleistung und Betrieb bereit. Die Modellkarte nennt Fehlalarme und übersehene Angriffe; das Modell ersetzt keine Herkunfts- oder Berechtigungsprüfung. Das separate Entscheidungsmodell stellen wir im Beitrag zu Wolf Defender Jev vor.
Cross-Session-Angriffe decken wir damit derzeit nicht ab. Die Grenzen zwischen Chats erläutert unser Cross-Session-Beitrag. Produktangaben geprüft am 14. Oktober 2026. Aus der hier besprochenen Studie folgt keine Aussage über Wolf Defenders Erkennungsleistung.
FAQ
Häufige Fragen
Was ist Prompt Injection gegen einen LLM-Judge?
Ein Angriff auf das Modell, das Inhalte bewertet. Fremder Text versucht dessen Urteil zu beeinflussen, etwa damit eine riskante Nachricht als unauffällig eingestuft wird.
Verhindert ein JSON-Ergebnis Prompt Injection?
JSON begrenzt das Ausgabeformat. Auch ein korrekt formatiertes Ergebnis kann eine falsche Bewertung enthalten. Die Anwendung muss Inhalt und Berechtigungen separat prüfen.
Ist eine hohe Modellkonfidenz eine sichere Freigabe?
Nein. Konfidenz ist eine Modelleinschätzung und kein Nachweis der Berechtigung. Kritische Aktionen brauchen unabhängig geprüfte Rechte und gegebenenfalls eine konkrete Nutzerfreigabe.
Ist Wolf Defender in Same Attack, Different Judge getestet worden?
Nein. Die besprochene Studie untersucht Jev, allgemeine LLM-Judges sowie Llama Guard 3 und Prompt Guard 2. Daraus lässt sich keine Leistungsaussage über Wolf Defender ableiten.
Wofür ist Wolf Defender gedacht?
Für die Textprüfung auf Single-Turn Prompt Injections. Das Modell ersetzt keine Berechtigungsprüfung und deckt derzeit keine Angriffsketten zwischen Chats ab.