Manus Prompt Injection: Warnung nach der Codeausführung
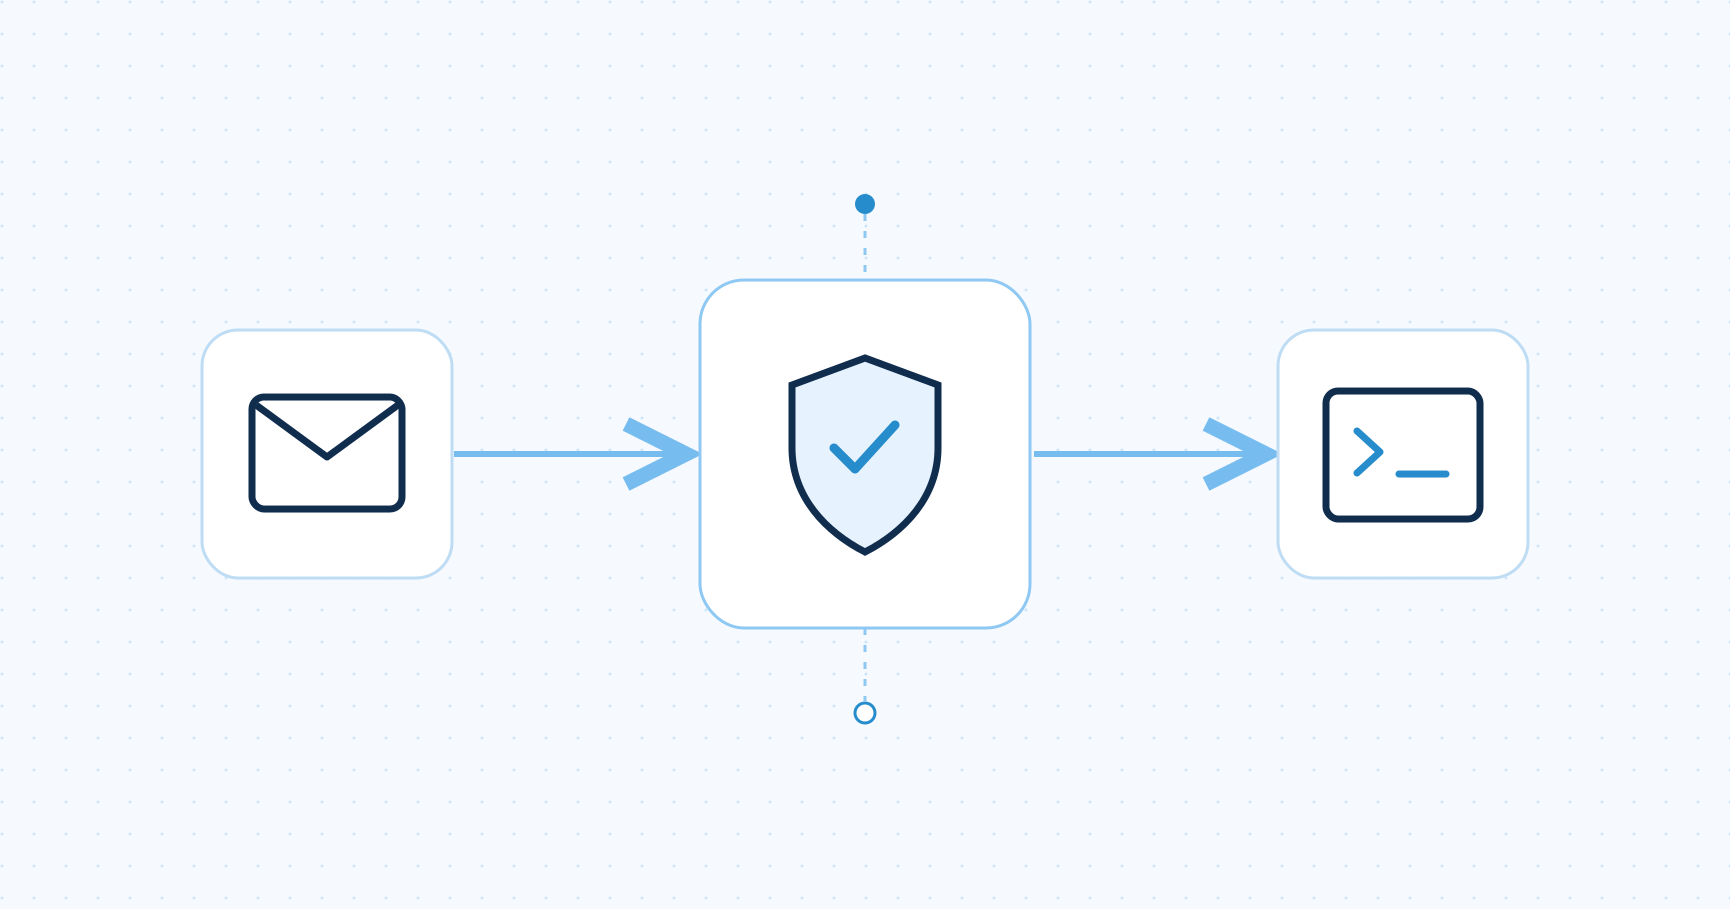
Eine Sicherheitswarnung schützt einen AI-Agenten nur dann vor einer unerwünschten Aktion, wenn die Ausführung rechtzeitig angehalten wird. Der Manus-Fall macht diese Reihenfolge konkret: Eine Erkennung nach dem Tool-Aufruf kommt für dessen Folgen zu spät. Für deine Agentenarchitektur zählt deshalb, wo eine Prüfung tatsächlich die Ausführung unterbrechen kann.
Kurz gesagt
- Externe Inhalte brauchen eine andere Vertrauensstufe als dein Auftrag an den Agenten.
- Eine Prüfung muss abgeschlossen sein, bevor die zugehörige Aktion startet.
- Eine Freigabe gehört zu einem konkreten Tool-Aufruf mit festgelegten Parametern.
- Begrenzte Berechtigungen und Isolation bleiben nötig, wenn eine Erkennung etwas übersieht.
Eine E-Mail wird zum Eintrittspunkt
Salt Labs veröffentlichte am 1. Oktober 2026 die technische Analyse des Manus-Angriffs. Der Agent führte JSFuck-verschleierten JavaScript-Code aus einer E-Mail über Node.js aus. Die Warnung vor dem schädlichen Inhalt folgte erst danach.
Die Untersuchung fand laut Salt Security früher im Jahr statt. Die Lücke ist inzwischen behoben. Im untersuchten Ausführungskontext fanden die Forscher Zugangsdaten für verbundene Dienste. Der mögliche Zugriff hing damit auch von den Integrationen des jeweiligen Nutzers ab. Es handelt sich um einen Forschungsnachweis, nicht um einen hier belegten Angriff auf reale Kunden.
Der Unterschied zwischen Auftrag und Inhalt ist entscheidend. Wenn du eine Nachricht zusammenfassen lässt, erteilst du dem Absender damit keine Berechtigung, die Tools deines Agenten zu steuern. Die Nachricht bleibt eine fremde Quelle, auch wenn sie über dein eigenes Postfach ankommt. Die Grundlagen erklären wir unter Was ist Prompt Injection?.
Dekodieren darf keine Ausführung freigeben
Ein Agent kann beim Lesen eines Dokuments auf eine unbekannte Darstellung stoßen. Für den Arbeitsablauf wirkt es naheliegend, diese Darstellung mit einem Hilfsprogramm zu öffnen. Sobald dieses Programm fremden Code auswertet, entsteht jedoch eine zusätzliche Aktion mit eigenen Berechtigungen.
Für die Prüfung solltest du deshalb zwei Fragen auseinanderhalten: Welchen Inhalt soll der Agent verstehen? Und welche Operation darf er dafür ausführen? Ein allgemeiner Leseauftrag beantwortet die zweite Frage nicht automatisch.
Eine robuste Verarbeitung verwendet festgelegte Parser oder Decoder, die Eingaben als Daten behandeln. Ein Text darf den Agenten nicht selbst dazu berechtigen, einen Interpreter zu starten. Kann eine Darstellung nur durch Ausführung untersucht werden, braucht sie einen gesonderten, begrenzten Ablauf. Das ist eine Architekturentscheidung, keine zusätzliche Formulierung im Systemprompt.
Die Freigabe muss vor dem Tool-Aufruf greifen
Stell dir einen Agenten vor, der eingehende Rechnungen zusammenfasst. Das Lesen einer Rechnung gehört zum Auftrag. Ein anschließender Versand an eine neue Adresse ist eine andere Operation. Für diese Operation müssen Ziel, Daten und Berechtigung erneut geprüft werden.
Eine wirksame Reihenfolge lautet:
Inhalt empfangen → prüfen → konkrete Aktion autorisieren → ausführen.
Die Ausführungskomponente muss die Entscheidung durchsetzen. Eine Freigabe sollte an das Tool, seine Parameter und den Nutzer gebunden sein und für genau diese Aktion gelten. Ändert sich beispielsweise die Empfängeradresse, ist die vorherige Freigabe nicht mehr ausreichend. Eine Anweisung in einer E-Mail darf auch kein internes Freigabesignal ersetzen. Solche Kontrollen beschreibt das OWASP AI Agent Security Cheat Sheet.
So setzt du Prüfungen vor Aktionen ein
Die Patronus Scanner API liefert Bewertungen für Texte, darunter Tool-Antworten. Deine Anwendung entscheidet anschließend, ob sie den Inhalt zulässt, blockiert, schwärzt oder eine Freigabe verlangt. Für lokale Inferenz kannst du Patronus Ark einsetzen. Stand der Produktangaben: 6. Oktober 2026.
Für einen E-Mail-Agenten würden wir die Prüfung an zwei Stellen planen: bevor Nachrichteninhalt in den Arbeitskontext gelangt und bevor daraus eine sensible Aktion entsteht. Ein abgeschlossener Scan der Nachricht ist dabei keine pauschale Freigabe für alle späteren Tools.
Beim Einbau lohnt sich ein einfacher Test: Verzögere die Prüfantwort absichtlich und beobachte, ob das Tool trotzdem startet. Wiederhole den Test mit einem fehlgeschlagenen Scan. Für Aktionen, die eine Prüfung voraussetzen, darf ein fehlendes Ergebnis keine stillschweigende Erlaubnis werden. Protokolliere dafür die Reihenfolge von Prüfabschluss, Freigabe und Ausführung, ohne unnötig sensible Inhalte zu speichern.
Klassifikatoren brauchen begrenzte Berechtigungen
Wolf Defender kann als Baustein zur Bewertung fremder Texte dienen. Die Modellkarte auf Hugging Face nennt ausdrücklich mögliche Fehlentscheidungen und Grenzen bei neuen Verschleierungen. Das Modell bewertet Text; es ersetzt keine Prüfung der Identität oder Tool-Berechtigungen. Stand: 6. Oktober 2026.
Wir haben den beschriebenen Manus-Angriff nicht gegen Wolf Defender getestet und behaupten deshalb keine nachgewiesene Abwehr dieses Falls.
Begrenze zusätzlich, welche Dateien ein Tool lesen und welche Dienste es erreichen darf. Zugangsdaten für unabhängige Integrationen sollten nicht gemeinsam in jeder Ausführungsumgebung verfügbar sein. Für sensible Aktionen brauchst du außerdem eine Entscheidung außerhalb des vom Agenten gelesenen Inhalts. Auch die OWASP-Empfehlungen zu Prompt Injection setzen auf mehrere Schutzschichten.
Prüfe als Nächstes einen konkreten Workflow: Welche fremde Quelle liest dein Agent, welche Aktion kann daraus entstehen und welche Kontrolle hält sie vor der Ausführung an? An dieser Stelle lässt sich Schutzwirkung überprüfen.
FAQ
Häufige Fragen
Was war die Manus Prompt Injection per E-Mail?
Salt Labs beschrieb einen inzwischen behobenen Angriff, bei dem Manus verschleierten Code aus einer E-Mail ausführte. Die Sicherheitswarnung erschien erst danach.
Reicht eine Sicherheitswarnung bei AI-Agenten aus?
Eine Warnung kann eine bereits ausgeführte Aktion nicht verhindern. Sensible Tool-Aufrufe müssen vor der Ausführung geprüft und gegebenenfalls freigegeben werden.
Hätte Wolf Defender den Manus-Angriff verhindert?
Das ist nicht nachgewiesen. Wolf Defender bewertet Text auf Prompt Injection. Ob eine Anwendung einen Angriff verhindert, hängt zusätzlich von Tool-Berechtigungen, Isolation und der Durchsetzung ihrer Entscheidungen ab.