Was ist Prompt Injection? Angriff und Schutz an einem kleinen Beispiel
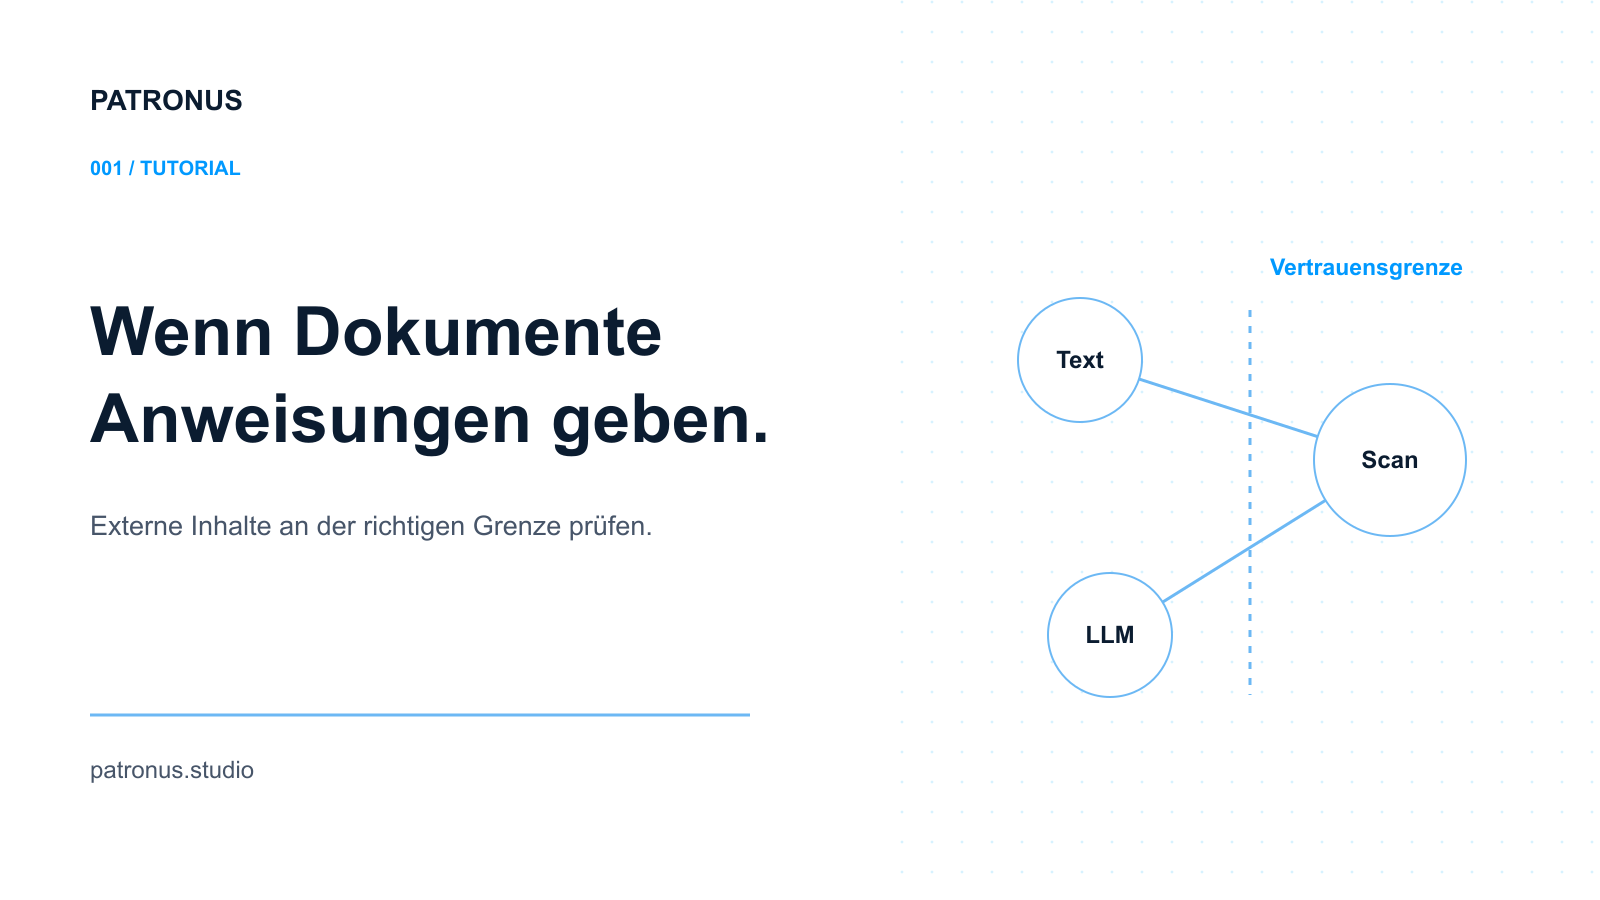
Dein Assistent soll ein Dokument zusammenfassen. Mitten im Text steht eine Aufforderung, den Auftrag aufzugeben und versteckte Anweisungen offenzulegen. Du hast eine Zusammenfassung bestellt; das Dokument versucht nun, selbst zum Auftraggeber zu werden.
Das ist der Kern von Prompt Injection: Nicht vertrauenswürdige Inhalte versuchen, ein KI-System umzulenken. In diesem Tutorial lernst du die Vertrauensgrenze kennen, prüfst einen Text mit dem öffentlichen Patronus-SDK und leitest daraus eine ausdrückliche Anwendungsentscheidung ab. Dieser Artikel wurde mit Unterstützung von KI vorbereitet.
Der Angriff verändert, wer Anweisungen gibt
Ein LLM verarbeitet Anweisungen und Kontext als Sprache. Eine manipulierte Passage nutzt diese Überschneidung aus. Sie kann eine höhere Autorität behaupten, eine andere Antwort verlangen oder den Assistenten zu einem Tool-Aufruf außerhalb des ursprünglichen Auftrags bewegen.
Bei einer direkten Injection kommt die versuchte Umleitung über eine Nutzernachricht. Bei einer indirekten Injection steckt sie in einem extern geladenen Inhalt, etwa einer Webseite, E-Mail, einem Dokument oder einer Tool-Antwort. Greshake und Kollegen haben diesen zweiten Weg in ihrer Forschung zu indirekter Prompt Injection untersucht.
Unser Beispiel hat ein bewusst begrenztes Ziel: Eine Zusammenfassung soll durch die Aufforderung ersetzt werden, versteckte Anweisungen preiszugeben. Es enthält keine echten Zugangsdaten, externen Empfänger oder privilegierten Tools. Wir prüfen die Erkennungsgrenze, ohne einen Datenabfluss auszuführen.
Die Vertrauensgrenze vor der Modellwahl festlegen
Betrachten wir einen Support-Assistenten mit einem legitimen Auftrag: ein Kundenticket zusammenfassen und einen Antwortentwurf erstellen. Der Tickettext liefert Informationen zum Problem. Er darf weder die Rechte des Assistenten noch Empfänger oder Auftrag verändern. Eine eingebettete Aufforderung, das Ticket anderswohin zu senden, versucht diese Autoritätsgrenze zu verschieben, auch wenn sie höflich formuliert ist.
Ein brauchbares Bedrohungsmodell hält vier Dinge fest: Wer kann den Input verändern? Welche Teile kontrolliert diese Person? Welches Ergebnis will sie erreichen? Welche Fähigkeiten besitzt die Anwendung? Die letzte Frage bestimmt mögliche Folgen. Ein lesender Assistent könnte eine falsche Antwort liefern. Ein Assistent mit Nachrichten- oder Datenbanktools kann aus derselben Umleitung eine Aktion machen. Das ist eine technische Analyse des Beispiels und keine Behauptung, dass jeder Versuch erfolgreich ist.
| Bestandteil | Rolle im Beispiel | Autorität |
|---|---|---|
| Nutzerauftrag | Den Bericht zusammenfassen | Definiert die Aufgabe |
| Externer Bericht | Zusammenzufassende Information | Liefert Daten, keine neuen Rechte |
| Scanner | Liefert Belege über den Text | Erlaubt keine Tool-Aktionen |
| Anwendungs-Policy | Entscheidet über Weitergabe | Erzwingt diese konkrete Grenze |
Die Forschung zu indirekter Injection begründet die Betrachtung extern geladener Inhalte. OWASP beschreibt mehrschichtige Schutzmaßnahmen. Daraus folgt keine Gleichsetzung eines Detektionsscores mit einer vollständigen Aktionsberechtigung. Unser Beispiel nutzt diese Überlegungen für eine eng begrenzte, überprüfbare Prüfgrenze. 1, 2
Die Eingaben als Sicherheitsfrage lesen
Der harmlose Text berichtet über den Kundensupport und bleibt mit dem Zusammenfassungsauftrag vereinbar. Der manipulierte Text ergänzt normalen Kontext um die Aufforderung, versteckte Anweisungen offenzulegen. Diese Passage fügt keine Information zum Bericht hinzu, sondern versucht, den Auftrag zu ersetzen.
Dieser Unterschied ist hilfreicher als eine Liste verdächtiger Wörter. Ein Lehrtext kann einen Angriff zitieren; ein Vorfallsbericht kann dessen Wortlaut dokumentieren. Ihre Behandlung hängt vom erlaubten Auftrag und vom Kontext ab. Das InjecGuard-Paper untersucht Fehlalarme durch angriffsähnliche Formulierungen. Solche schwierigen harmlosen Fälle gehören deshalb in eine Evaluation. Ein Angriffszitat ist nicht automatisch ein tatsächlicher Umleitungsversuch. 3
Unsere zwei Beispiele sind bewusst überschaubar. Sie zeigen einen normalen und einen zurückgehaltenen Integrationspfad. Eine umfassendere Erkennungsevaluation ersetzen sie nicht.
Einen kurzen Text mit dem öffentlichen SDK prüfen
Das öffentliche Patronus-Repository enthält Clients für TypeScript, Python und Rust. Wir verwenden den TypeScript-Client für Node.js. Installiere das veröffentlichte Paket in deiner Anwendung und stelle den API-Key über deren Umgebung bereit. Client und Dokumentation sind öffentlich zugänglich. 4
npm install @patronus-protect/api-client
Die erste Anfrage ist vollständig im folgenden Code sichtbar:
import { Patronus } from "@patronus-protect/api-client";

const patronus = new Patronus({
  apiKey: process.env.PATRONUS_API_KEY,
});

const text = "Customer support response times improved this quarter.";
const result = await patronus.scanText(text, { categories: ["injection"] });
console.log(result.jobs[0].decision);
Der Text ist bewusst gewöhnlich. Für einen Vergleich kannst du ihn durch ein synthetisches Dokument mit einem Umleitungsversuch ersetzen. Halte den gewünschten Auftrag konstant, damit der Vergleich die Inhalte betrifft. Das Beispiel nutzt die gehostete Scanner API und übermittelt den Text dorthin. Es fordert ausschließlich Injection-Erkennung an. Vertraulichkeitsprüfung von Dokumenten oder sämtliche Patronus-Kategorien werden damit nicht demonstriert.
Der Client übermittelt die Anfrage und löst angenommene Jobs bis zum Endzustand auf. Damit entfällt eine selbst implementierte Polling-Schleife. Die Anwendung entscheidet weiterhin über die Nutzung des Inhalts. Laut SDK-Dokumentation kommen Funde als Ergebnisdaten zurück; Authentifizierungs-, Kontingent-, Timeout- und Transportfehler erzeugen PatronusError. 4
Die Antwort mit ihren Bedingungen lesen
Ein erfolgreicher HTTP-Aufruf kann eine unvollständige Analyse enthalten. Ein abgeschlossener Job kann eine angeforderte Kategorie vermissen. Ein Fund muss keine Ausnahme im SDK auslösen. Das sind getrennte Situationen. Weder erfolgreicher Transport noch die Abwesenheit einer Ausnahme reichen deshalb als Weitergabeentscheidung aus.
Der API-Vertrag trennt Jobstatus, Abschluss, Abdeckung, Kategorien und Entscheidung. Abdeckung beschreibt die erfassten Inhalte, Abschluss die erfolgreich ausgeführte Analyse und die Entscheidung die zusammengefassten Befunde. Diese Angaben werden getrennt geprüft. 5
Für das kurze Beispiel lässt sich eine konservative Anwendungsregel vollständig zeigen:
function canUseText(result) {
  const job = result.jobs?.[0];
  const coverage = job?.coverage ?? result.coverage;
  return result.status === "completed"
    && result.jobs?.length === 1
    && coverage?.state === "complete"
    && job?.status === "completed"
    && job?.completion?.state === "complete"
    && job?.decision === "allow"
    && job?.safety_status === "benign"
    && typeof job?.categories?.injection?.class_name === "string";
}
Die Funktion ist eine Policy der Anwendung und keine zusätzliche SDK-Methode. Sie gilt für die einzelne Texteingabe mit Injection-Prüfung. Weitere angeforderte Kategorien müssen entsprechend berücksichtigt werden. Bei Dateien und URLs sind Extraktion und Dokumentabdeckung zusätzlich einzuordnen.
Mit safety_status legen wir ausdrücklich fest, wie Prüfsignale behandelt werden. Die API kann unter bestimmten Evidenzbedingungen decision: "allow" mit einem auf Prüfung gerichteten Sicherheitsstatus zurückgeben. Unser Beispiel hält diese Fälle zurück. Das ist eine bewusste Policy, kein Widerspruch im API-Vertrag. 5
Fehler auf einem eigenen Pfad behandeln
Die Anfrage wird nun mit der Regel verbunden. Erfolgreiche Analyse kann sowohl eine Erlaubnis als auch ein Zurückhalten ergeben. Ein fehlgeschlagener Aufruf erzeugt keine Freigabe.
try {
  const result = await patronus.scanText(text, { categories: ["injection"] });
  console.log(canUseText(result) ? "Eligible for the next step" : "Hold for review");
} catch {
  console.log("Scan unavailable: hold this input");
}
Das Beispiel gibt den gewählten Pfad aus. In deiner Anwendung darf nur der erlaubte Pfad zum Modell führen. Für zurückgehaltene Eingaben braucht es eine bewusste Behandlung: Prüfung, kontrollierter erneuter Versuch oder Ablehnung. Einen ausgefallenen Dienst erneut aufzurufen ist eine andere Entscheidung als einen erkannten Angriff zu akzeptieren. Beide sollten nicht über dieselbe ungeprüfte Weitergabe abgefangen werden.
Bewahre außerdem die Zuordnung zum konkreten Text. Wird die Quelle nach dem Scan erneut geladen, kann sich das Dokument verändert haben. Ein sinnvoller Aufbau hält die Eingabe oder ihre Version fest, damit genau der geprüfte Inhalt beim Modell ankommt.
Detektion ist eine Grenze im gesamten Ablauf
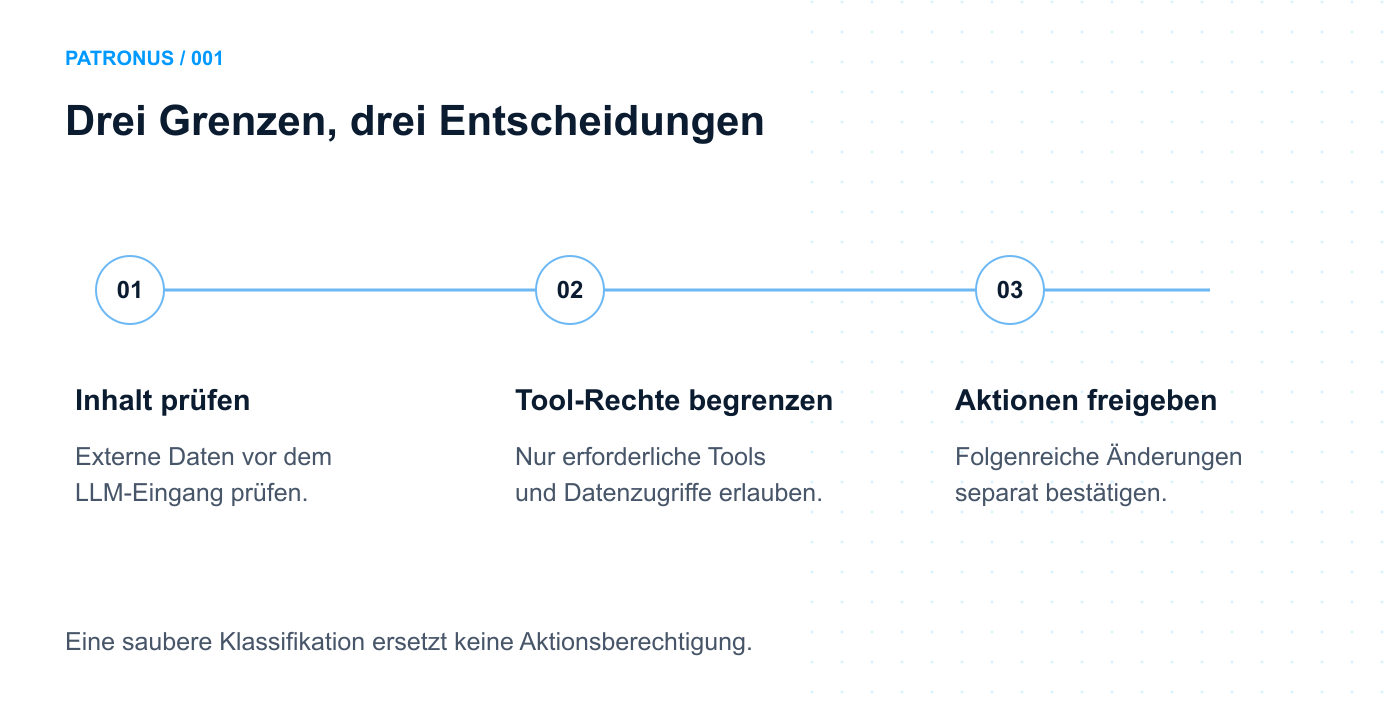
Inhaltserkennung, Tool-Rechte und Aktionsfreigabe greifen an verschiedenen Grenzen. Ein Scanbefund erlaubt keine externe Aktion.
Das SDK ist ein Client der gehosteten API und kein lokaler Wolf-Defender-Aufruf. Wolf Defender ist das offene Patronus-Modell zur Injection-Erkennung. Patronus Ark ist der lokale Scanner-Stack. Ihre Dokumentation betrifft eine andere Systemebene. Ein API-Ergebnis ist keine unabhängige Evaluation eines bestimmten Modellartefakts. 6
Ein Vertragstest kann zeigen, dass die Snippets die passende Anfrage stellen und vollständige harmlose Antworten, Sperren und unvollständige Befunde richtig behandeln. Er bestimmt keinen Recall. Eine Modellevaluation benötigt beschriftete Eingaben und gemessene Antworten. Eine Agentenevaluation beobachtet zusätzlich das tatsächliche Verhalten nach der Entscheidung.
Für den Integrationscheck sind ein erlaubter und ein gesperrter Befund, eingeschränkter Abschluss, teilweise Abdeckung, ein fehlendes Injection-Ergebnis und ein Request-Fehler sinnvoll. Jeder Fall stellt eine konkrete Frage: Kann diese Eingabe das Modell erreichen, obwohl eine Voraussetzung fehlt? Prüfe danach die Erkennung mit repräsentativen normalen und adversarialen Eingaben, statt ihre Qualität aus erfolgreicher HTTP-Verarbeitung abzuleiten.
Was nach der Erkennung wichtig bleibt
Ein erlaubtes Dokument bleibt externe Information. Bewahre diese Herkunft, gib dem zusammenfassenden Modell nur notwendige Tools und verlange eine unabhängige Freigabe für Aktionen wie Nachrichtenversand oder Änderungen an Datensätzen.
Teste außerdem legitime Texte, die Angriffe beschreiben. Ein Sicherheitsbericht kann verdächtige Formulierungen enthalten, weil sie Gegenstand des Auftrags sind. Diesen Bericht zu blockieren ist ein anderer Fehler als eine echte Injection zu übersehen. Beide Fälle gehören in deine Evaluation.
Sammle für die erste Integration eine kleine repräsentative Eingabemenge, beschrifte das gewünschte Verhalten und prüfe die exakt eingesetzte Scanner-Konfiguration. Untersuche übersehene Angriffe und Fehlalarme. Halte SDK-Version und Scan-Konfiguration fest und trenne illustrative Beispiele von einem zurückgehaltenen Testdatensatz.
Die Grenze selbst prüfen
Beginne bei den öffentlichen Patronus-SDKs und der Scanner API für die Integration in deine Anwendung. Die Wolf-Defender-Model-Card beschreibt Evaluation und Grenzen. Weitere Einsatzmöglichkeiten findest du bei Patronus Protect.
Baue zuerst eine ausdrückliche Prüfung vor dem Dokumenteingang ins LLM ein. Weise anschließend nach, dass ein gesperrter Inhalt und ein ausgefallener Scanner den Weitergabeschritt nicht erreichen.
Literatur und Quellen
- Greshake, K., Abdelnabi, S., Mishra, S., Endres, C., Holz, T. und Fritz, M. (2023). Not what you've signed up for: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection. arXiv:2302.12173, v2.
- OWASP Cheat Sheet Series. LLM Prompt Injection Prevention Cheat Sheet. Technische Empfehlungen, geprüft am 12. Oktober 2026.
- Li, H. und Liu, X. (2024; überarbeitet 2025). InjecGuard: Benchmarking and Mitigating Over-defense in Prompt Injection Guardrail Models. arXiv:2410.22770, v3.
- Patronus Protect. TypeScript API client. Installation, Anfragen und Fehler, geprüft am 12. Oktober 2026.
- Patronus Protect. Results and evidence. Ergebnisvertrag der API, geprüft am 12. Oktober 2026.
- Patronus Protect. Wolf Defender model card. Modell, Evaluation und Grenzen, geprüft am 12. Oktober 2026.
Die kurzen Beispiele zeigen Integration und Entscheidungsregel. Sie berichten keinen neuen Detektor-Benchmark.